法院文件披露:OpenAI被指未经授权使用1000万篇新闻文章
基本属实
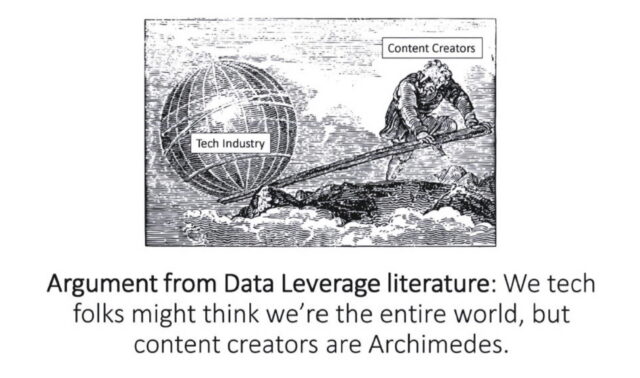
公开的法院文件显示,OpenAI被指未经授权使用多达1000万篇新闻媒体报道的文章用于AI训练,此事引发对生成式AI企业版权合规问题的新一轮关注。相关内容经YTN报道,其图片来自法院及OpenAI、微软的官方公开文件。
오픈AI, 언론사 기사 1천만 건 무단 사용 법원 문서 공개
法院文件曝光训练数据争议
公开的法院文件显示,OpenAI涉嫌在未经授权的情况下,将约1000万篇新闻媒体文章用作大语言模型(LLM)的训练数据。这一争议属于新闻机构针对OpenAI及微软提起的版权诉讼的一部分,涉案文件此前由法院公开。
YTN报道与官方文件来源
YTN对此事进行了报道。据说明,报道相关图像源自法院以及OpenAI、微软的官方页面直接公开的文件,未使用自行制作或二次加工的图像。这表明争议核心内容可以直接追溯到公开法律文书。
对韩国AI与媒体行业的影响
该事件再次凸显生成式AI企业在数据获取上的版权风险。对于韩国本土的Naver等从事LLM研发的企业,以及内容产业而言,海外同类诉讼的进展具有直接的参照意义。不过,涉案具体规模与法律认定结果仍需等待法院后续审理确认。
综合目前公开的法院文件与媒体报道,OpenAI未经授权使用约1000万篇新闻文章的指控有公开文件支持,但最终法律定性尚未落定,总体判定:基本属实
Sources — primary documents (12)
- https://arstechnica.com/tech-policy/2026/09/microsoft-exec-called-ai-scraping-the-largest-theft-of-labor-in-human-history/
- https://www.theverge.com/ai-artificial-intelligence/997312/a-microsoft-exec-called-ai-scraping-theft-of-unprecedented-proportions
- https://arstechnica.com/tech-policy/2026/09/microsoft-exec-called-ai-scraping-the-largest-theft-o
- https://www.ocregister.com/2026/09/17/new-docs-in-a-i-copyright-suit-reveal-startling-admission-by-microsoft-exec-over-astonishing-theft-2/
- https://www.ytn.co.kr/_ln/0104_202609181053541746
- https://www.nytco.com/press/the-new-york-times-sues-openai-and-microsoft/
- https://www.yt
- https://www.trtworld.com/article/6aa6364eba7d
- https://www.courtlistener.com/docket/69286466/new-york-times-company-v-microsoft-corporation/
- https://nytco-assets.nytimes.com/2023/12/Lawsuit-Document-NYT-Complain.pdf
- https://www.ndtv.com/world-news/new-york-times-alleges-microsoft-openai-knew-using-news-content-was-theft-12062290
- https://cdn.arstechnica.net/wp-content/uploads/2026/09/via-News-Plaintiffs-Microsoft-internal-doc-cartoon-e1789673962449-640x378.jpg