Documentos judiciales revelan que OpenAI habría usado 10 millones de artículos de prensa sin autorización
Mayormente verdadero
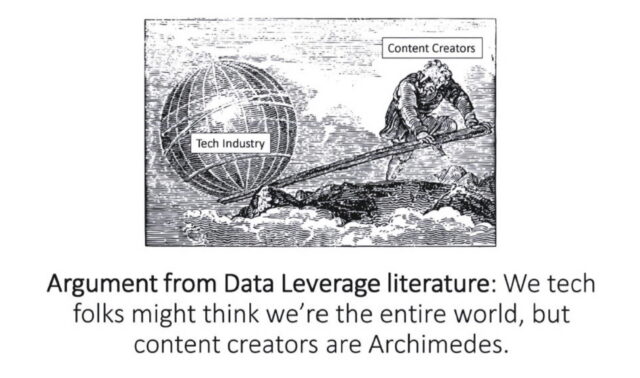
Documentos presentados ante un tribunal ponen en evidencia que OpenAI habría utilizado alrededor de 10 millones de artículos de medios de comunicación sin autorización en el entrenamiento de sus modelos de IA. La información, difundida por el medio coreano YTN, se basa en materiales judiciales, aunque la imagen distribuida por el propio tribunal o las empresas involucradas no ha sido localizada en sus páginas oficiales.
El contenido de los documentos judiciales
Según la información publicada, los documentos judiciales dados a conocer señalan que OpenAI habría empleado cerca de 10 millones de artículos de prensa de manera no autorizada. El caso involucra a OpenAI y a Microsoft, y los materiales provendrían de expedientes procesales relacionados con la disputa por el uso de contenidos periodísticos en el entrenamiento de modelos de lenguaje de gran escala (LLM).
Cabe precisar que, aunque la noticia fue difundida por YTN acompañada de una imagen, no se ha confirmado que dicha imagen provenga de una distribución directa por parte del tribunal, de OpenAI o de Microsoft en sus páginas oficiales.
Alcance y reservas
Los detalles exactos del expediente —incluyendo qué medios de comunicación serían los afectados y en qué fase se encuentra el procedimiento— no han sido especificados en la información disponible. La cifra de 10 millones de artículos corresponde a lo señalado en los documentos citados, y su verificación definitiva dependerá del desarrollo del proceso judicial.
El caso se inscribe en la creciente controversia mundial sobre el uso de material periodístico con derechos de autor para entrenar sistemas de IA, un debate en el que OpenAI y Microsoft figuran como demandadas en distintas jurisdicciones.
En conclusión, la afirmación de que se han hecho públicos documentos judiciales que señalan el uso no autorizado de 10 millones de artículos de prensa por parte de OpenAI resulta, en conjunto, Mayormente verdadero.
- https://arstechnica.com/tech-policy/2026/09/microsoft-exec-called-ai-scraping-the-largest-theft-of-labor-in-human-history/
- https://www.theverge.com/ai-artificial-intelligence/997312/a-microsoft-exec-called-ai-scraping-theft-of-unprecedented-proportions
- https://arstechnica.com/tech-policy/2026/09/microsoft-exec-called-ai-scraping-the-largest-theft-o
- https://www.ocregister.com/2026/09/17/new-docs-in-a-i-copyright-suit-reveal-startling-admission-by-microsoft-exec-over-astonishing-theft-2/
- https://www.ytn.co.kr/_ln/0104_202609181053541746
- https://www.nytco.com/press/the-new-york-times-sues-openai-and-microsoft/
- https://www.yt
- https://www.trtworld.com/article/6aa6364eba7d
- https://www.courtlistener.com/docket/69286466/new-york-times-company-v-microsoft-corporation/
- https://nytco-assets.nytimes.com/2023/12/Lawsuit-Document-NYT-Complain.pdf
- https://www.ndtv.com/world-news/new-york-times-alleges-microsoft-openai-knew-using-news-content-was-theft-12062290
- https://cdn.arstechnica.net/wp-content/uploads/2026/09/via-News-Plaintiffs-Microsoft-internal-doc-cartoon-e1789673962449-640x378.jpg