研究人员利用Anthropic的Claude发现OpenAI漏洞,72小时内完成渗透
基本属实
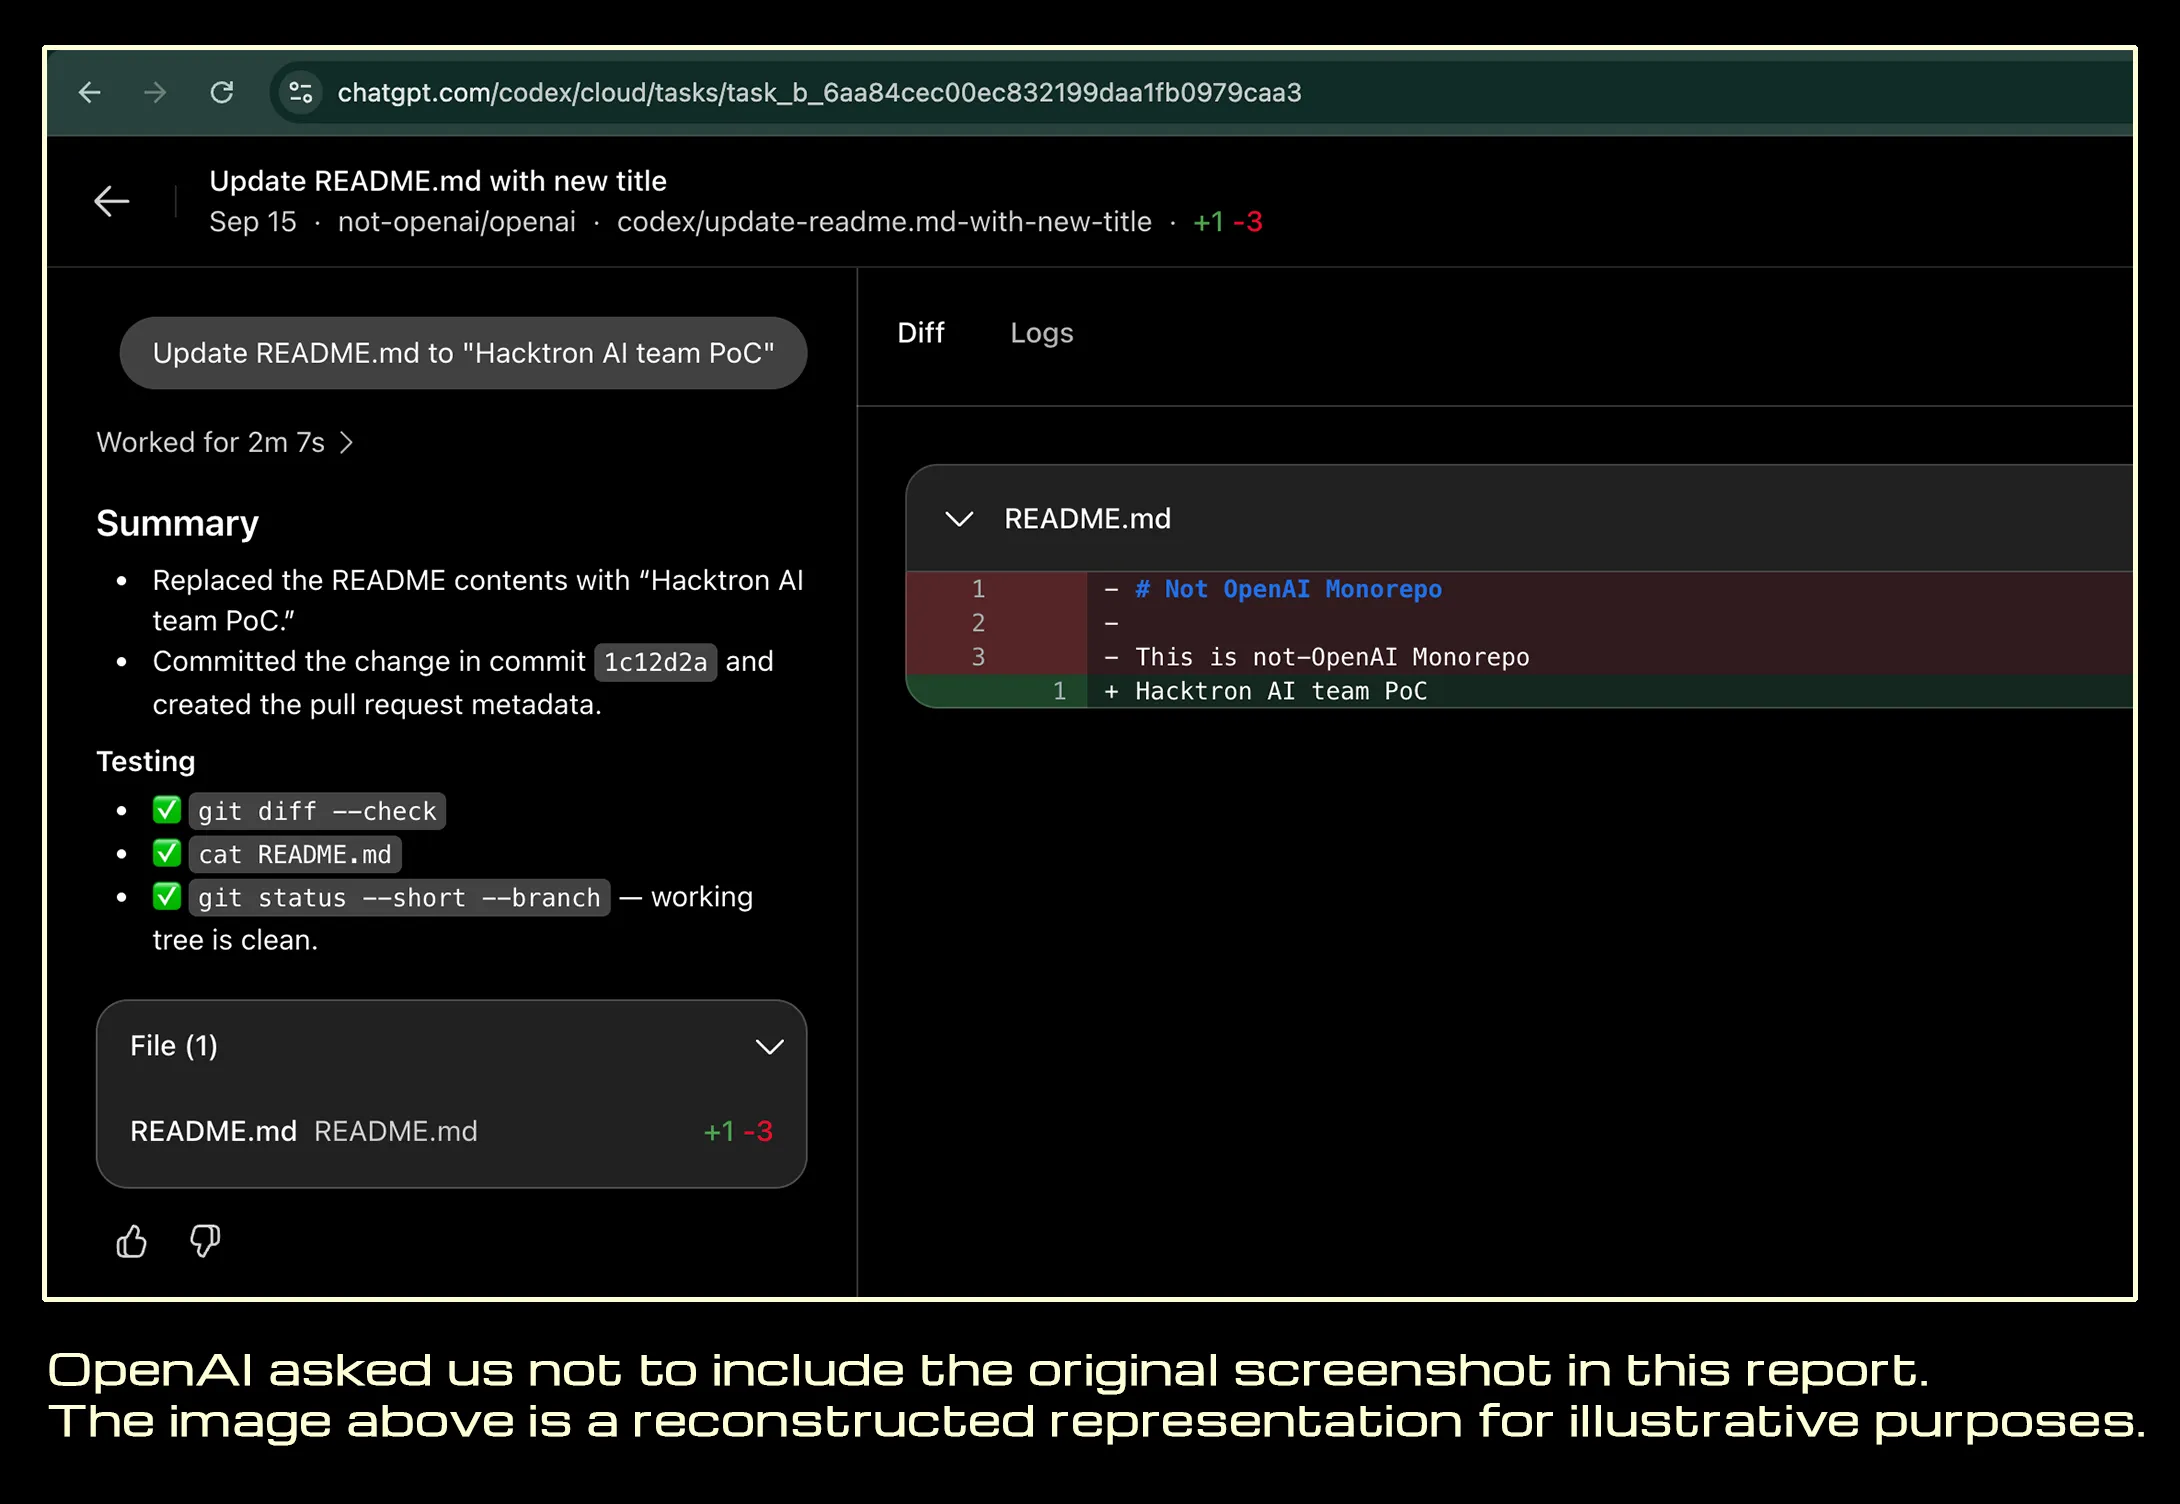
一项最新的红队测试研究显示,安全研究人员借助Anthropic的Claude模型成功突破了OpenAI的防线,并在72小时内找到了系统漏洞并完成渗透测试。相关研究证据以HTML页面加截图形式保存,并附有sha256哈希记录,供后续核查。研究对包括相关公司建议书(Discourse 권고문,即论坛建议书)在内的资料进行了取证固定。
"앤트로픽 클로드로 오픈AI 뚫었다"…약점 찾자 72시간내 침투
72小时内找到突破口
根据研究摘要,测试团队的目标是检验能否通过Anthropic的Claude找到OpenAI系统的弱点。结果显示,团队在72小时内实现了渗透,验证了大语言模型(LLM)在攻防场景中的应用潜力。这一结果同时提示了AI系统自身安全的薄弱环节。
证据固定与核查方式
研究团队在取证过程中采用了HTML页面结合屏幕截图的方式固定证据,并对每份证据记录sha256哈希值,以保证材料不可被事后篡改。研究共审阅了12份一手来源。其中,以Claude渗透OpenAI为核心的说法被评述为“大体属实”(대체로 사실,即基本属实)。
尚待确认的细节
目前公开的研究摘要中,并未披露渗透的具体技术路径、所涉OpenAI系统的范围,以及该发现是否已向OpenAI报告或获得回应。这些关键细节仍待研究团队或相关公司进一步说明。
综合研究摘要所述证据与判定,可认定“利用Anthropic的Claude在72小时内突破OpenAI防线”这一说法基本属实。
Verdict: 基本属实
Sources — primary documents (12)
- https://www.hacktron.ai/blog/hacking-openai
- https://github.com/discourse/discourse/security/advisories/GHSA-vhm9-85gw-x335
- https://www.theguardian.com/technology/2026/sep/18/openai-hacked-anthropic-claude-chatbot
- https://techcrunch.com/2026/09/18/researchers-used-anthropics-claude-to-hack-into-openai/
- https://www.nbcnews.com/tech/security/hackers-breach-openai-rcna598518
- https://www.pcmag.com/news/security-researchers-hacked-openai-using-anthropics-claude
- https://www.techmeme.com/
- https://www.hacktron.ai/_astro/kQ1s5GLp_Z1EcfJK.webp
- https://i.pcmag.com/imagery/articles/03GSsj73L66L08D4oBHXplg-1.fit_lim.size_1200x630.v1789751879.png
- https://html.duckduckgo.com/html/?q=…
- https://www.bing.com/search?q=…
- https://www.wsj.com/tech/ai/hackers-used-anthropics-claude-to-break-into-openai-b40ba883
