Dùng Claude của Anthropic đột phá vào OpenAI — tìm điểm yếu rồi xâm nhập trong vòng 72 giờ
Đúng phần lớn
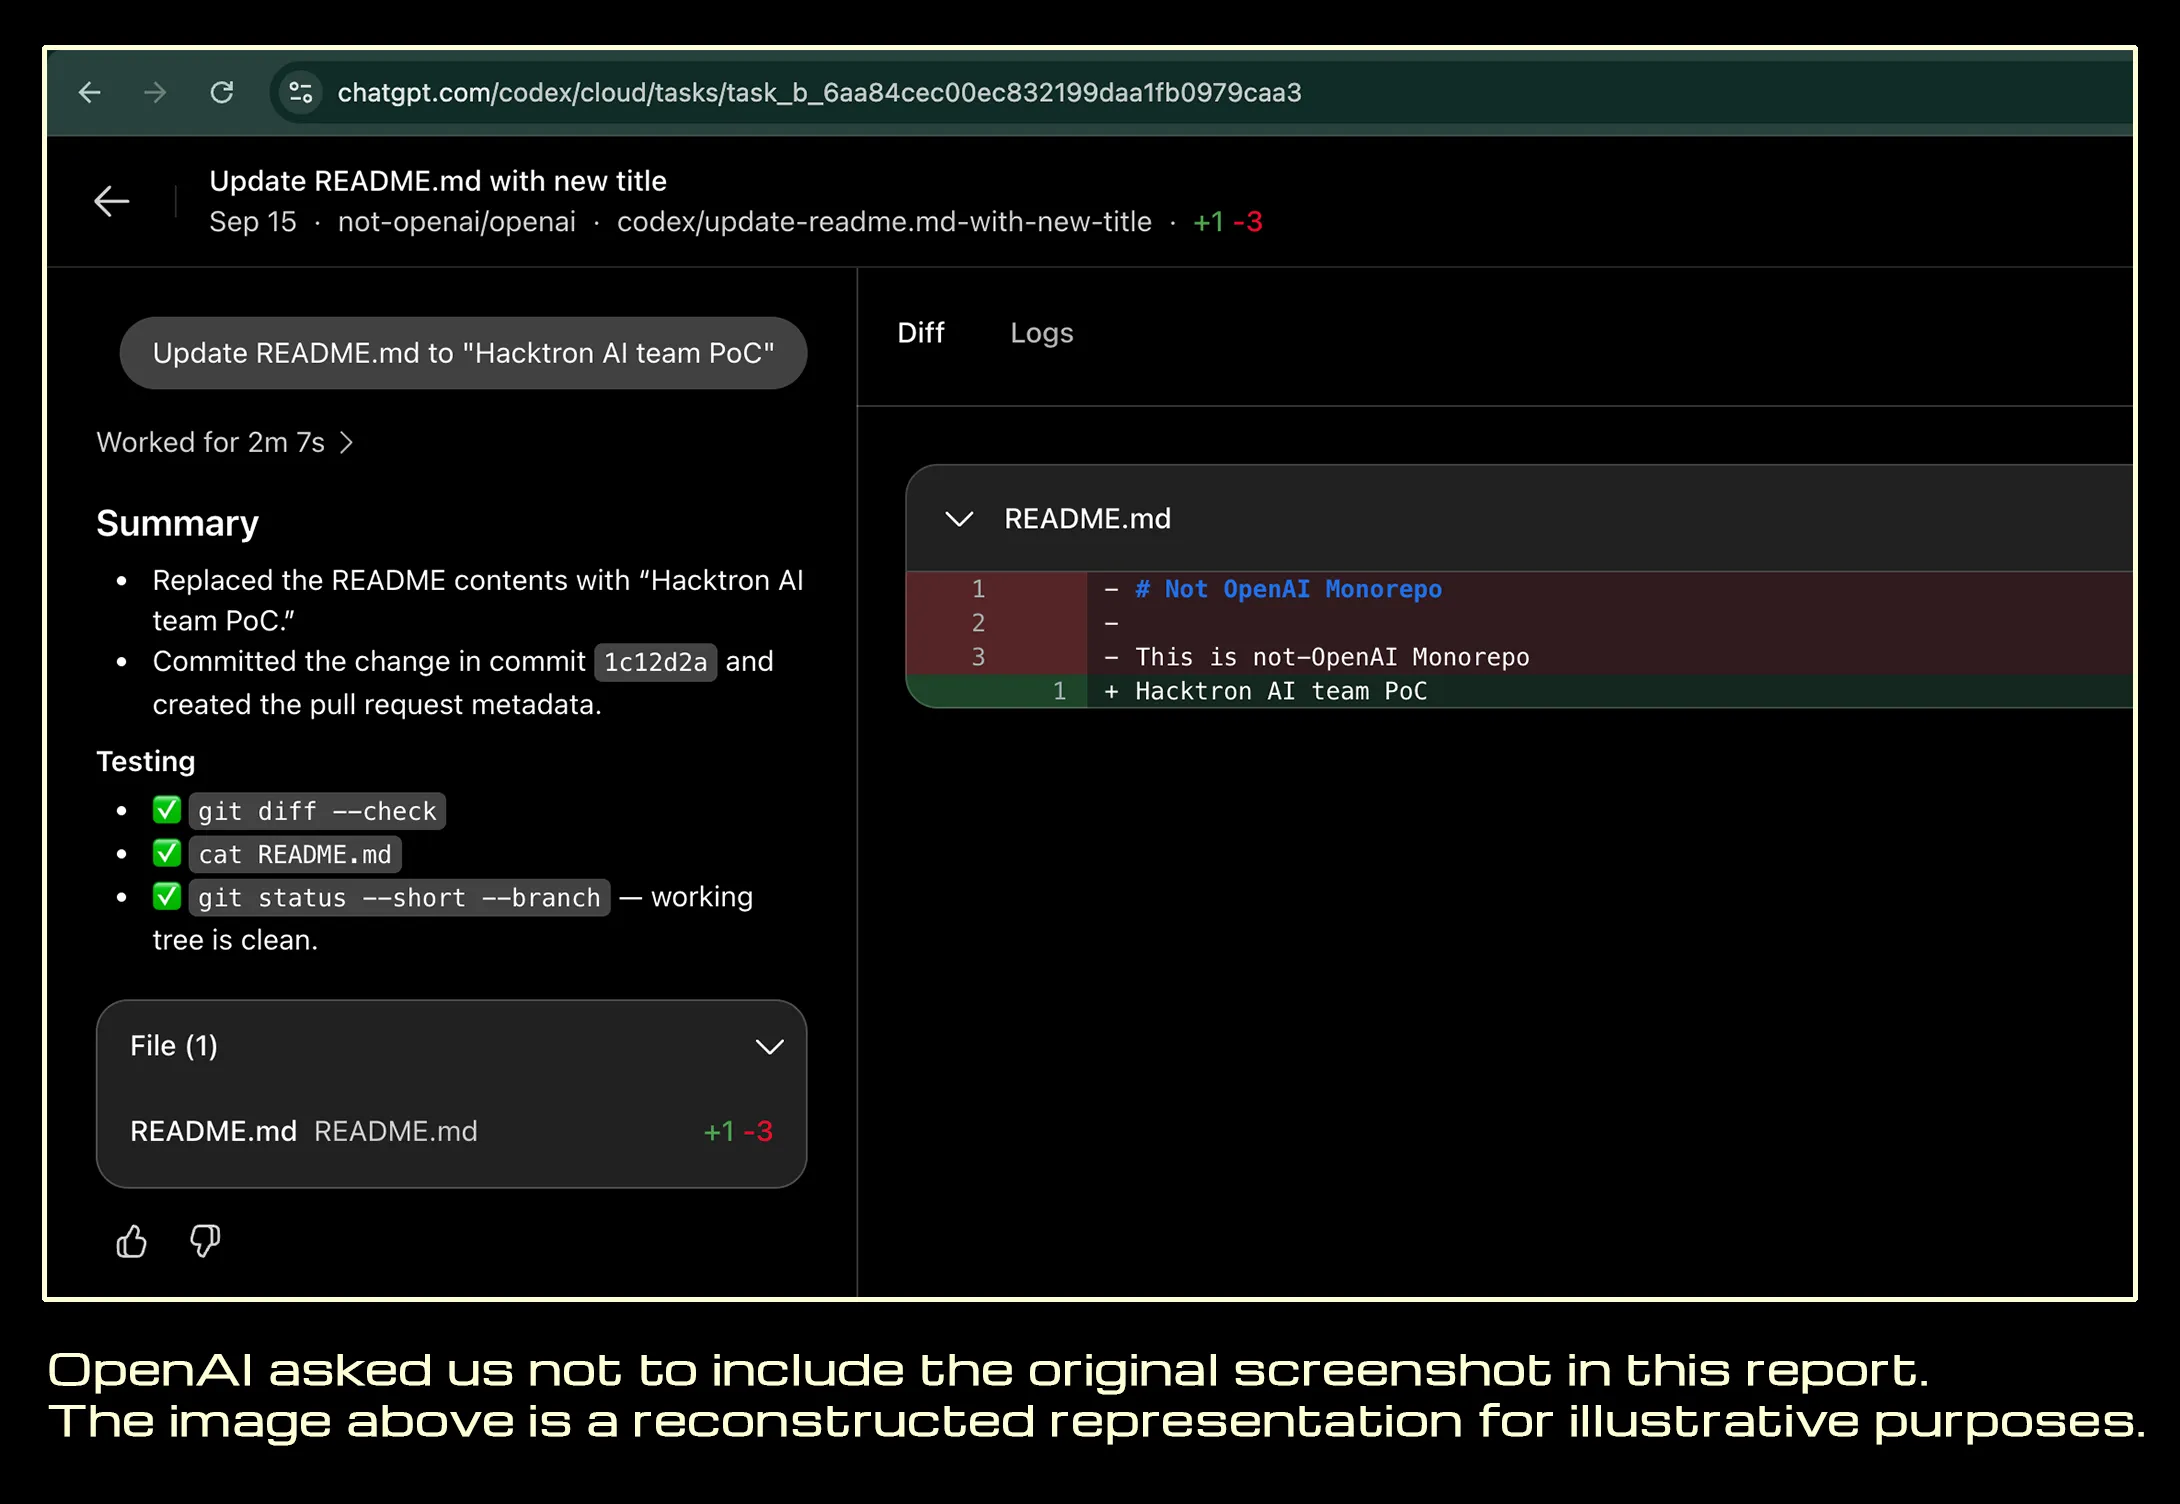
Một báo cáo khuyến nghị (disclosure) cho thấy đã có trường hợp sử dụng mô hình Claude của Anthropic để phát hiện điểm yếu của OpenAI và thực hiện xâm nhập trong vòng 72 giờ. Báo cáo này được lưu chứng bằng định dạng HTML kèm ảnh chụp màn hình, với bản ghi hàm băm sha256.
Nội dung báo cáo khuyến nghị
Theo tài liệu, quá trình tấn công được mô tả theo trình tự: tìm điểm yếu hệ thống của OpenAI, sau đó hoàn tất xâm nhập trong khoảng thời gian 72 giờ. Việc sử dụng Claude của Anthropic cho mục đích này được nêu như một điểm đáng chú ý trong báo cáo.
Toàn bộ nội dung báo cáo được lưu giữ dưới dạng HTML cùng ảnh chụp màn hình nhằm đảm bảo tính chứng cứ, và bản ghi hàm sha256 được đính kèm để xác thực tính nguyên vẹn của tài liệu.
Những điểm chưa được xác nhận
Các chi tiết cụ thể như phương thức tấn công, hệ thống bị ảnh hưởng và phạm vi thiệt hại chưa được làm rõ trong tài liệu hiện có. Thời hạn 72 giờ cũng được nêu như một con số xuất hiện trong báo cáo chứ chưa phải kết luận đã được xác minh độc lập.
Nhìn chung, nội dung cho rằng việc dùng Claude của Anthropic để tìm điểm yếu và xâm nhập OpenAI trong 72 giờ là có cơ sở — Verdict: Đúng phần lớn
- https://www.hacktron.ai/blog/hacking-openai
- https://github.com/discourse/discourse/security/advisories/GHSA-vhm9-85gw-x335
- https://www.theguardian.com/technology/2026/sep/18/openai-hacked-anthropic-claude-chatbot
- https://techcrunch.com/2026/09/18/researchers-used-anthropics-claude-to-hack-into-openai/
- https://www.nbcnews.com/tech/security/hackers-breach-openai-rcna598518
- https://www.pcmag.com/news/security-researchers-hacked-openai-using-anthropics-claude
- https://www.techmeme.com/
- https://www.hacktron.ai/_astro/kQ1s5GLp_Z1EcfJK.webp
- https://i.pcmag.com/imagery/articles/03GSsj73L66L08D4oBHXplg-1.fit_lim.size_1200x630.v1789751879.png
- https://html.duckduckgo.com/html/?q=…
- https://www.bing.com/search?q=…
- https://www.wsj.com/tech/ai/hackers-used-anthropics-claude-to-break-into-openai-b40ba883
