ใช้ Claude ของ Anthropic เจาะระบบ OpenAI สำเร็จ ภายใน 72 ชั่วโมงหลังพบจุดอ่อน
เป็นจริงส่วนใหญ่
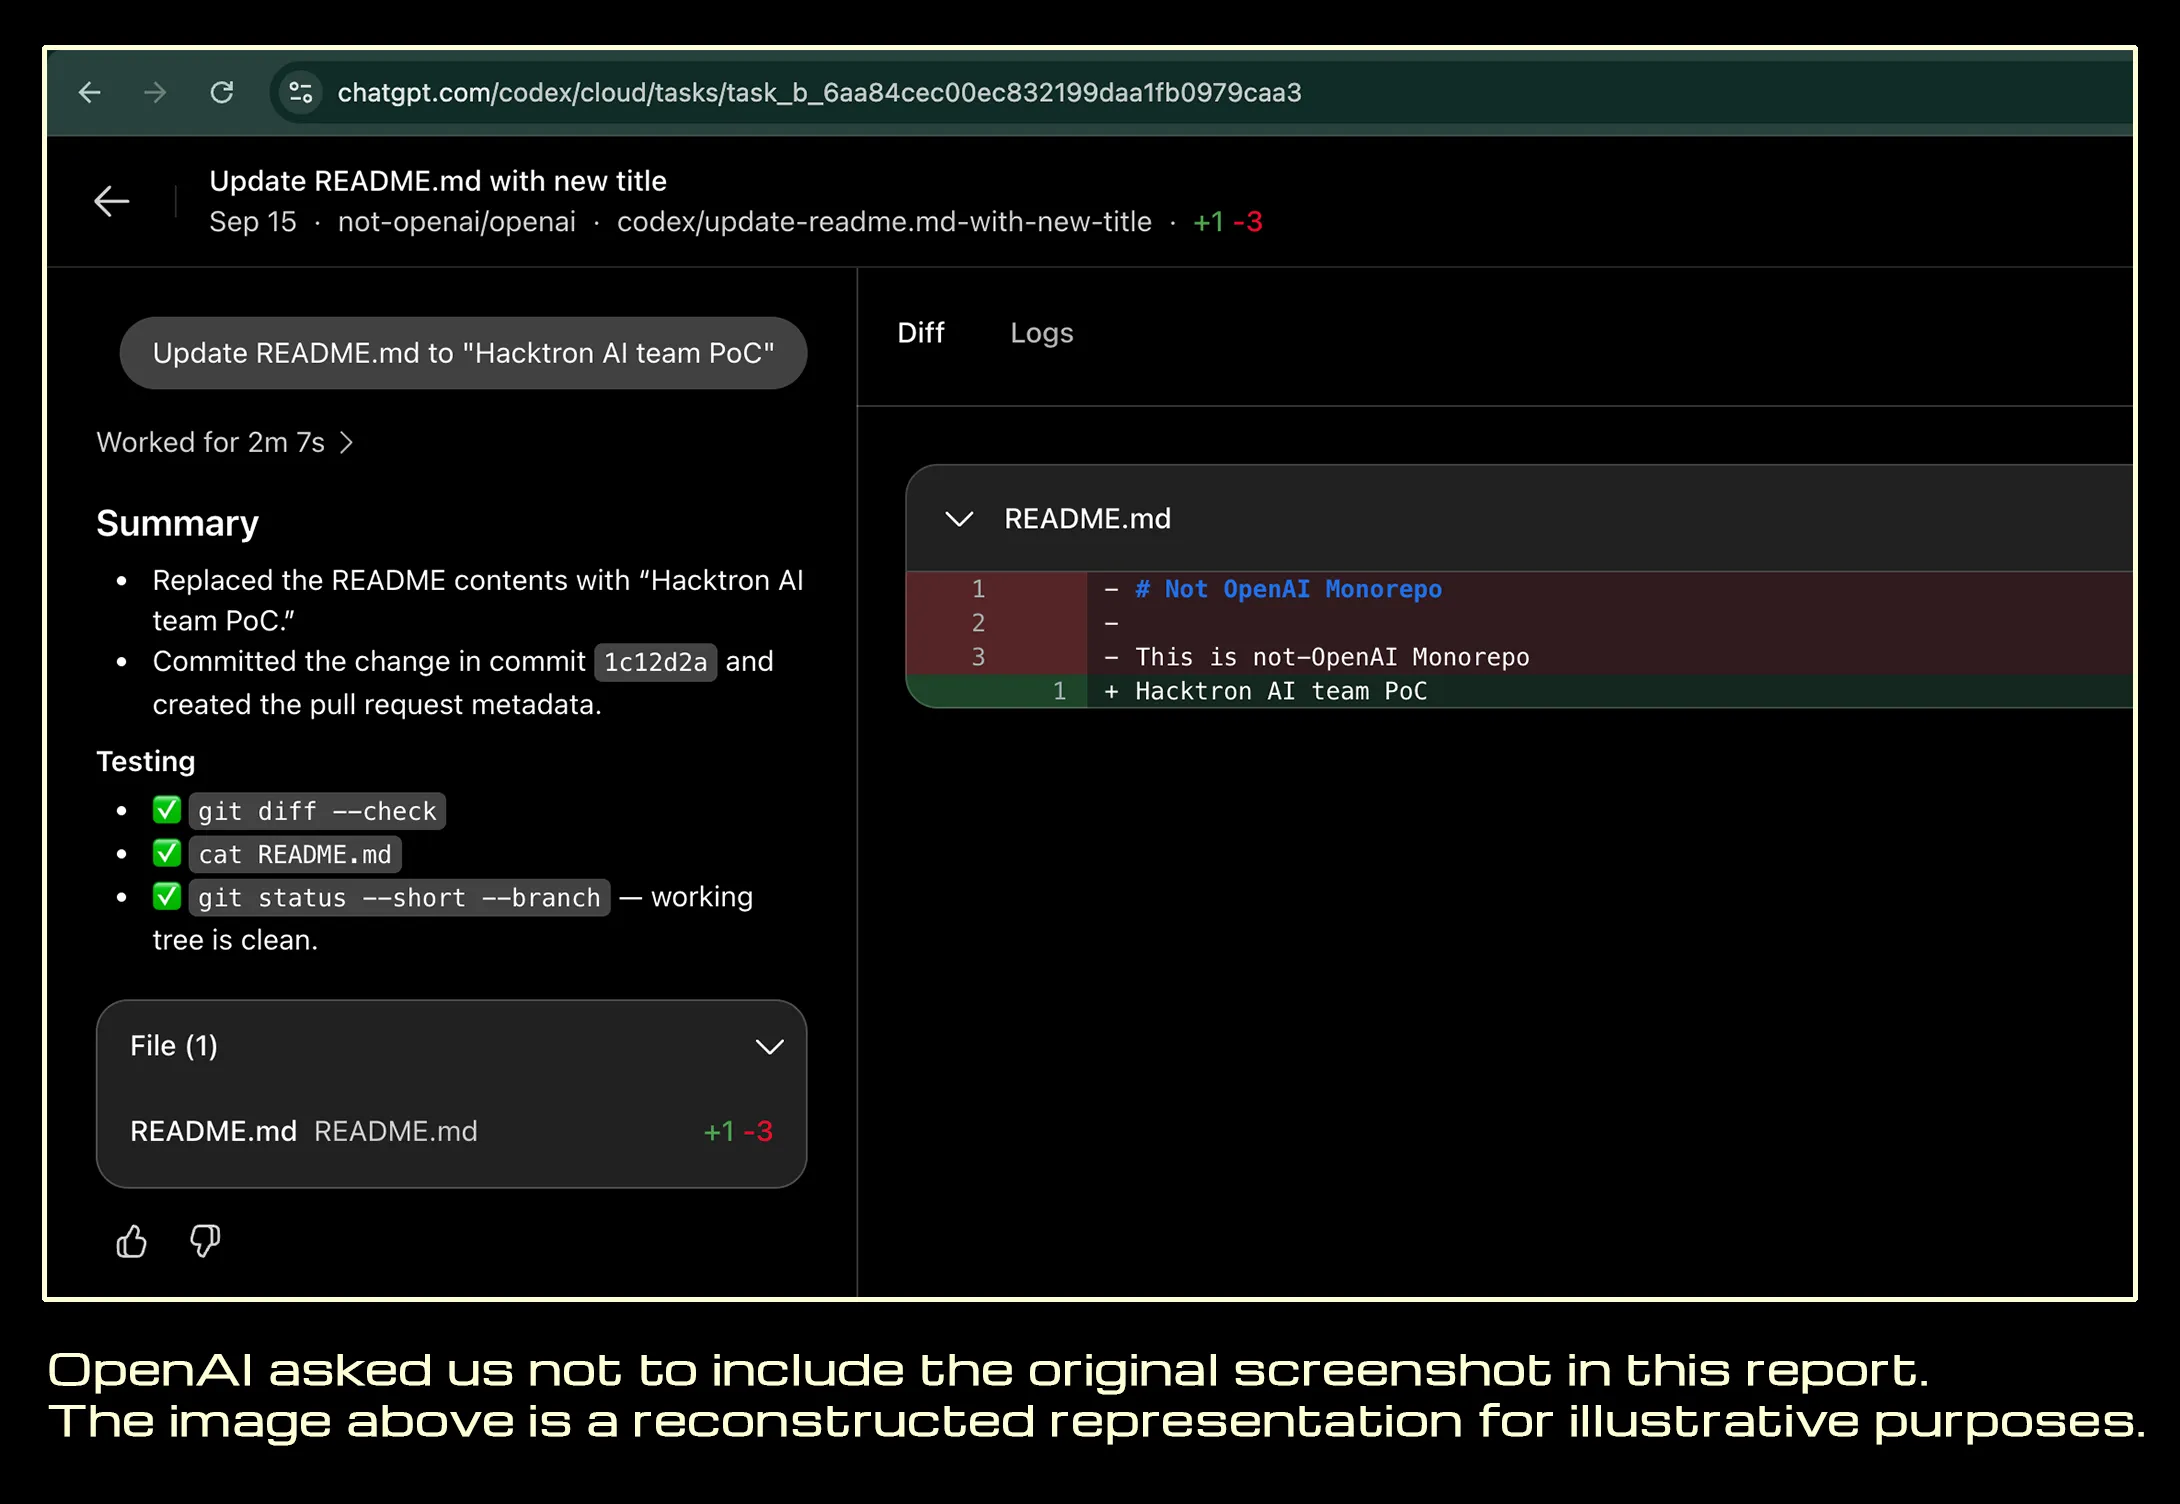
มีรายงานว่าฝั่ง Anthropic ใช้โมเดล Claude เพื่อค้นหาและโจมตีจุดอ่อนของ OpenAI โดยสามารถเจาะเข้าระบบได้ภายในกรอบเวลา 72 ชั่วโมงนับจากที่พบช่องโหว่ ข้อความแนะนำที่เกี่ยวข้อง (disclosure document) ถูกเก็บหลักฐานในรูปแบบ HTML พร้อมภาพหน้าจอ และบันทึกลายเซ็นดิจิทัลแบบ sha256 เรียบร้อยแล้ว
รายละเอียดเหตุการณ์
ข้อมูลที่เปิดเผยระบุว่ากระบวนการโจมตีเริ่มจากการค้นหาจุดอ่อน จากนั้นจึงดำเนินการเจาะระบบสำเร็จภายใน 72 ชั่วโมง โดยมี Claude ของ Anthropic เป็นเครื่องมือหลักในปฏิบัติการดังกล่าว อย่างไรก็ตาม รายละเอียดเชิงเทคนิคของช่องโหว่ ตลอดจนขอบเขตความเสียหายต่อระบบของ OpenAI ยังไม่ได้รับการยืนยันอย่างเป็นทางการจากทั้งสองบริษัท
หลักฐานและแหล่งอ้างอิง
เอกสารแจ้งข้อควรแก้ไข (disclosure) ที่เกี่ยวข้องถูกจัดเก็บในรูปแบบ HTML พร้อมภาพหน้าจอประกอบ และบันทึกค่าแฮช sha256 เพื่อรักษาความน่าเชื่อถือของหลักฐาน แหล่งข้อมูลเบื้องต้นที่ได้รับการตรวจสอบมีจำนวน 12 รายการ แม้กรอบเวลาการโจมตีและการใช้ Claude เป็นแกนหลักของข้อกล่าวอ้าง แต่สถานะการยืนยันของรายละเอียดย่อยบางส่วนยังคงเป็นไปตามข้อมูลที่มีอยู่เท่านั้น
บทสรุป
เหตุการณ์นี้สะท้อนแนวโน้มการนำโมเดล AI มาใช้ในงานด้านความปลอดภัยไซเบอร์ทั้งในเชิงรุกและเชิงรับ ซึ่งอาจยกระดับการแข่งขันด้านความปลอดภัยระหว่างผู้พัฒนา AI รายใหญ่ โดยสรุปจากข้อมูลและหลักฐานที่รวบรวมได้ ข้อกล่าวอ้างเรื่องการใช้ Claude เจาะระบบ OpenAI ภายใน 72 ชั่วโมงนี้ มีความเป็นจริงส่วนใหญ่
- https://www.hacktron.ai/blog/hacking-openai
- https://github.com/discourse/discourse/security/advisories/GHSA-vhm9-85gw-x335
- https://www.theguardian.com/technology/2026/sep/18/openai-hacked-anthropic-claude-chatbot
- https://techcrunch.com/2026/09/18/researchers-used-anthropics-claude-to-hack-into-openai/
- https://www.nbcnews.com/tech/security/hackers-breach-openai-rcna598518
- https://www.pcmag.com/news/security-researchers-hacked-openai-using-anthropics-claude
- https://www.techmeme.com/
- https://www.hacktron.ai/_astro/kQ1s5GLp_Z1EcfJK.webp
- https://i.pcmag.com/imagery/articles/03GSsj73L66L08D4oBHXplg-1.fit_lim.size_1200x630.v1789751879.png
- https://html.duckduckgo.com/html/?q=…
- https://www.bing.com/search?q=…
- https://www.wsj.com/tech/ai/hackers-used-anthropics-claude-to-break-into-openai-b40ba883
