AI · SEMICONDUCTOR · FACT CHECK
 SKD WIRE
IBM Research와 Red Hat 주도 오픈소스 프로젝트 llm-d가 1.0 정식 버전을 공개하고, 특정 조건에서 AI 추론 비용을 기존의 5분의 1에서 10분의 1 수준으로 줄일 수 있다고 밝혔습니다. 수치는 당사자 벤치마크 결과라는 점에서 해석에 절제가 필요합니다.
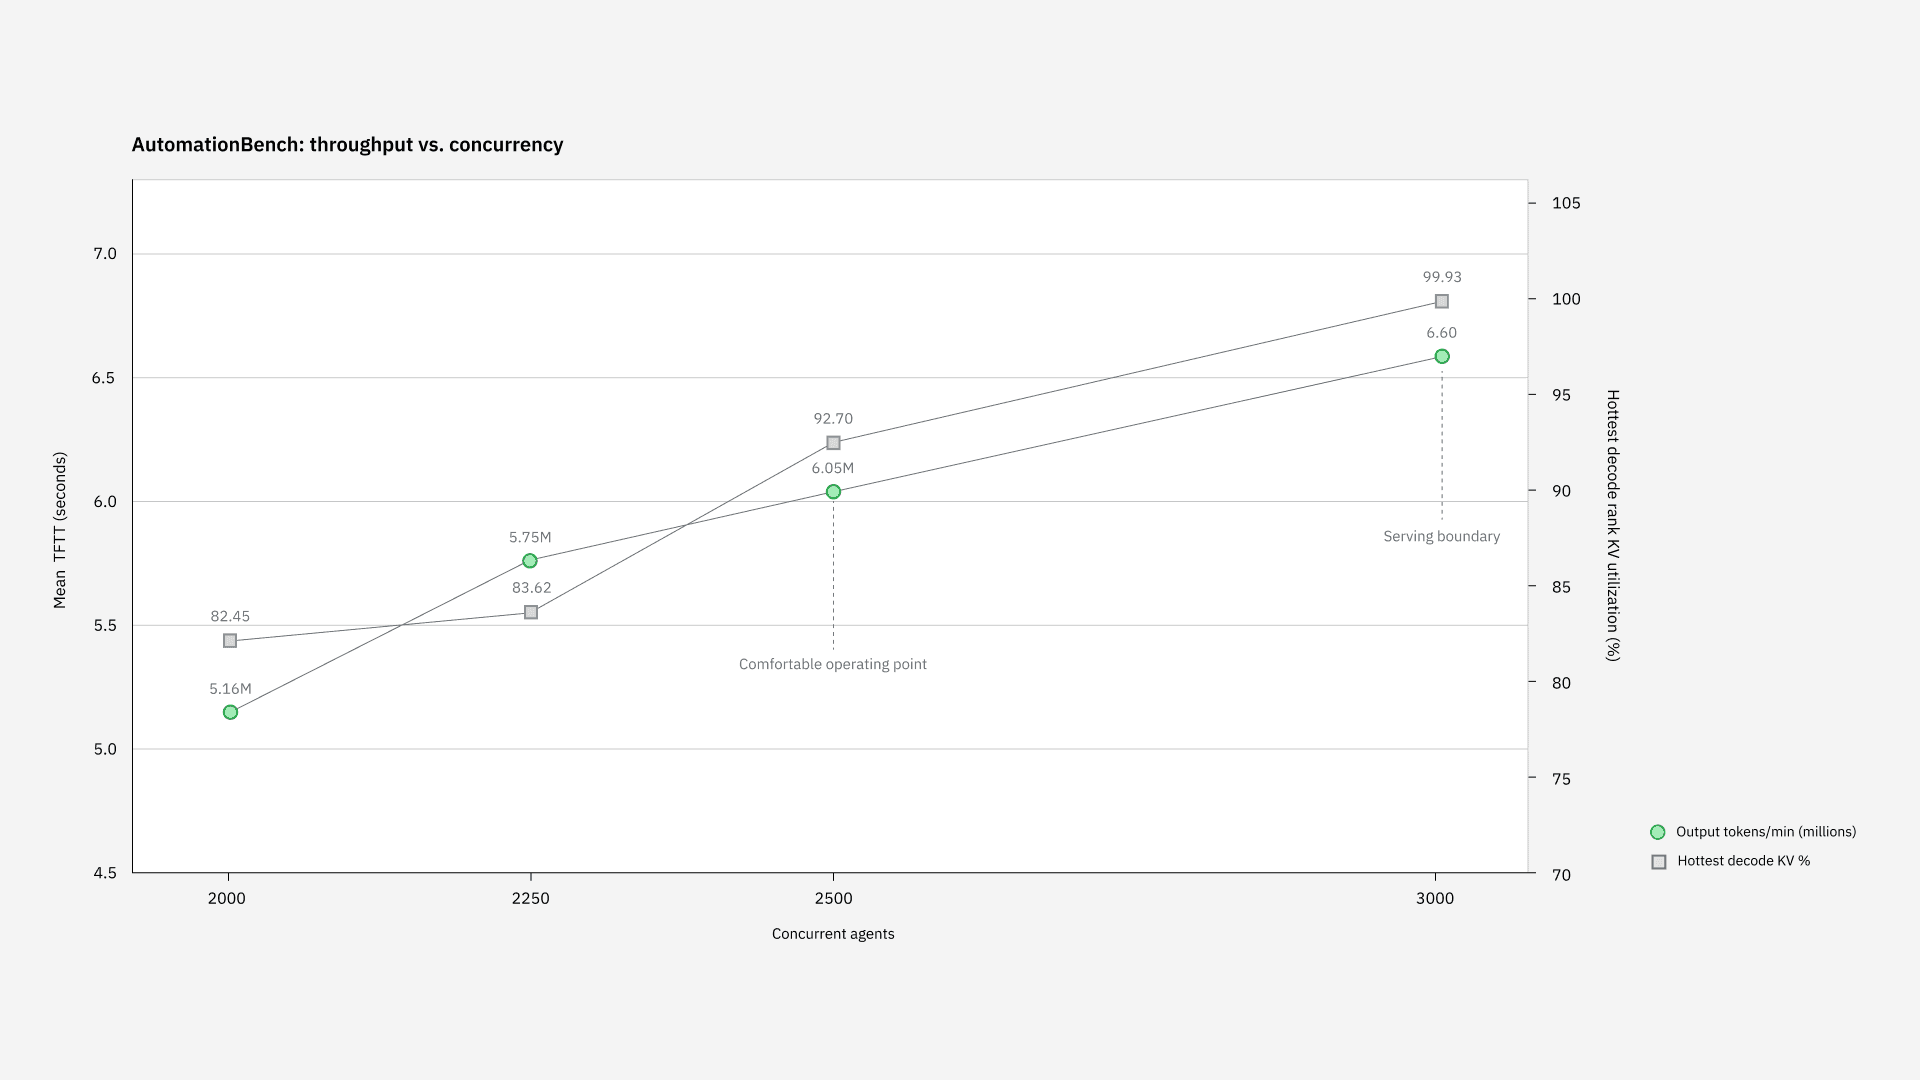
llm-d 프로젝트 발표에 따르면 절감 수치는 GLM 5.2 모델을 H100 GPU 544장에서 구동한 벤치마크 데모에서 나왔습니다. 비교 기준은 상용 API 정가이며, 클라우드 GPU 임대료를 환산한 자체 운영비와 대비한 결과입니다. 발표문은 입력 위주의 에이전트 워크로드와 특정 임대 요금·API 가격을 전제한 조건부 상한이라고 밝혔습니다. 인력·전력·유휴율을 포함한 총소유비용 관점의 검증은 아직 이뤄지지 않았습니다.
출처: 조사 출처
프로젝트 공식 사이트 llm-d.ai와 GitHub 저장소, IBM 뉴스룸 발표문에는 1.0 릴리스 내용이 일치하게 실려 있습니다. 발표문에 따르면 llm-d는 쿠버네티스 환경에서 대규모 언어 모델 추론을 효율화하는 오픈소스 프레임워크로, 기업용 AI 대규모 운영을 겨냥합니다. GKE 연동, Vera Rubin·AMD 하드웨어 대응 등 주요 발표 내용도 원문과 부합합니다.
다만 논문 형태로 인용된 일부 수치는 여러 출처에서 확인되지 않았습니다. 동일 제목의 논문이 arXiv 검색에서 검출되지 않아 '11.5배' 절감 주장은 단일 기둥 위에 서 있는 상태입니다. 헤드라인이 원문의 '5~10분의 1' 범위 중 상한만 취해 '최대 10분의 1'로 축약한 점도 함께 짚어둘 필요가 있습니다.
절감 주장은 당사자가 자신의 환경에서 측정한 수치이며, 제3자가 동일 조건에서 재현한 결과는 아직 확인되지 않았습니다. 다른 모델·다른 하드웨어·실제 운영 환경에서 같은 비용 구조가 유지되는지는 몇 분기의 관측이 더 필요합니다. 총소유비용 기준의 독립 측정이 나올 때까지 수치는 조건부 참고값으로 읽는 것이 타당합니다.
종합하면 오픈소스 llm-d 1.0의 공개와 주요 발표 내용은 1차 출처들과 대체로 사실이며, 비용 절감 수치만큼은 당사자 벤치마크의 조건부 최대치임을 감안해 해석해야 합니다. 향후 독립 벤치마크와 다양한 워크로드에서의 재현 결과가 이 주장의 무게를 결정지을 것입니다.