AI · SEMICONDUCTOR · FACT CHECK
 SKD WIRE
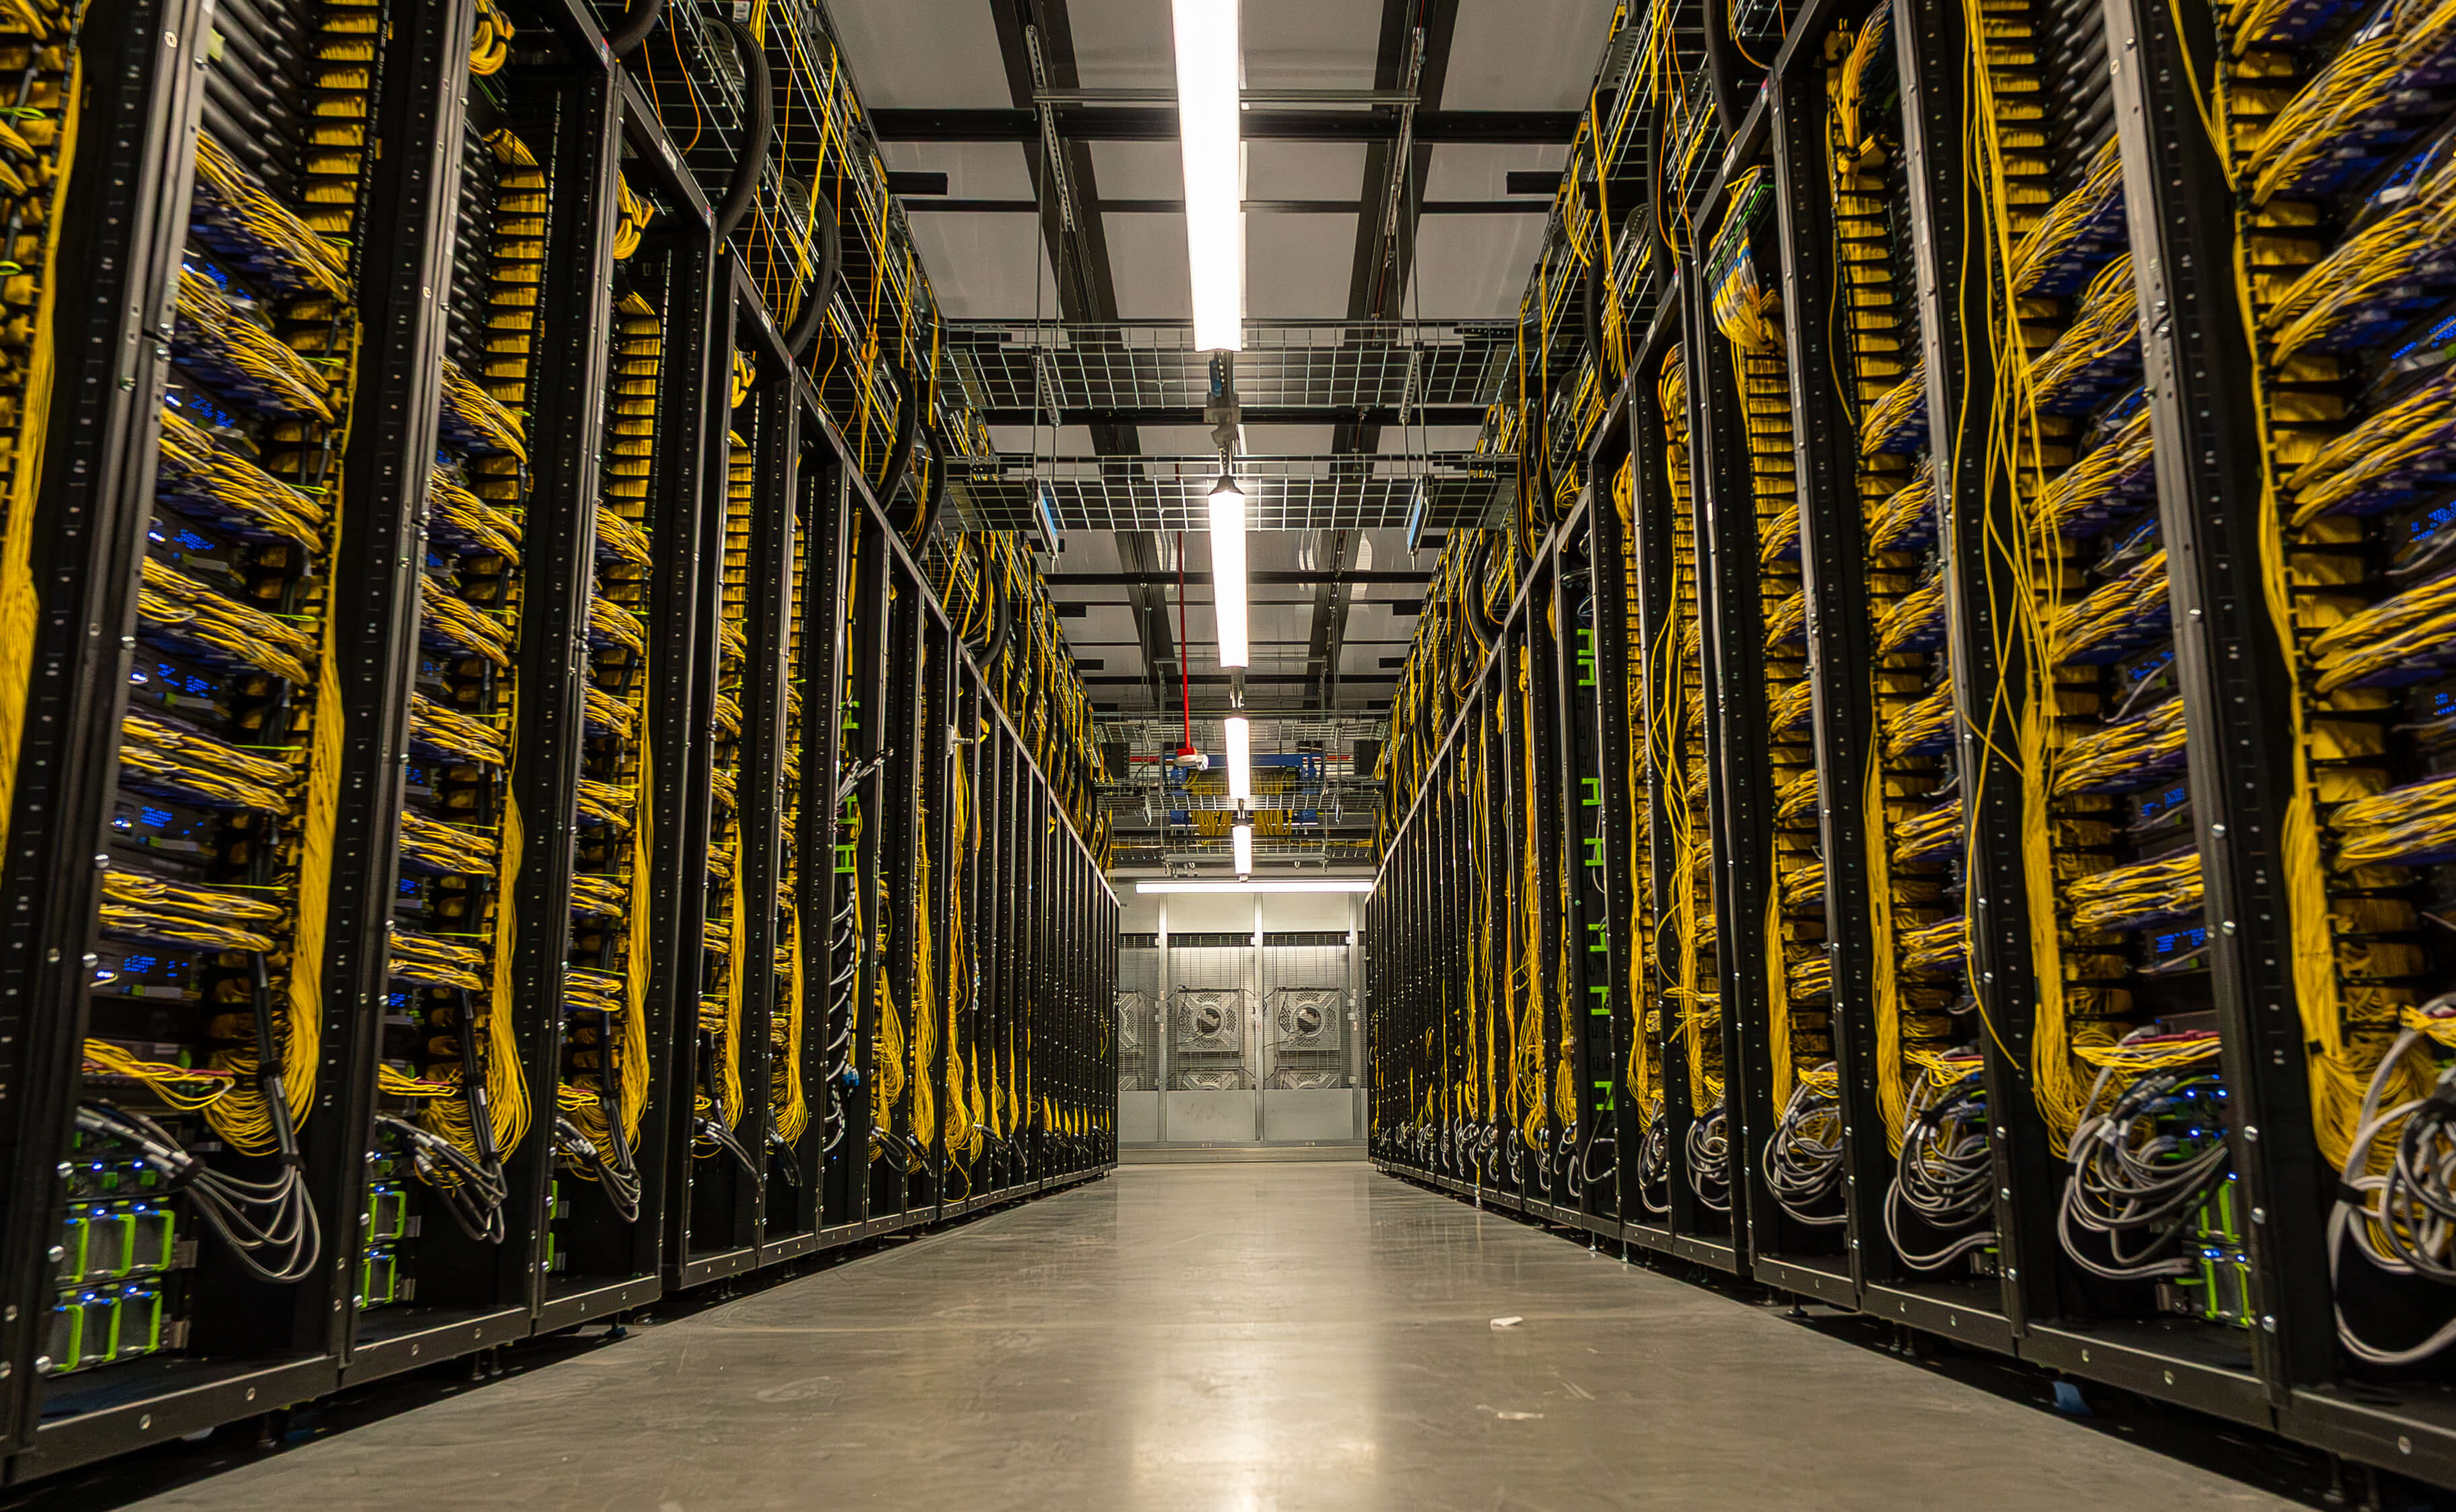
메타가 뮤즈 AI 모델 학습을 뒷받침하는 대규모 인프라 프로메테우스를 공개하며 사전학습 goodput을 85% 끌어올렸습니다. 다만 이는 학습 연산의 10~15%가 여전히 장애 복구에 소모됨을 함께 의미합니다.
메타 엔지니어링 블로그에 따르면 회사는 GPU 장애가 초기 학습의 주요 병목이었으나 안정성은 해결 가능한 공학적 과제라고 전했습니다. 발표문 전체에서 병목을 완전히 없앴다는 표현은 등장하지 않았습니다. 메타 스스로 8K GPU 클러스터 기준 일 2건 장애, 평균 장애 간격 약 10만 GPU시간이라는 목표치를 제시하고 아직 미달 상태임을 명시했습니다.
출처: 조사 출처
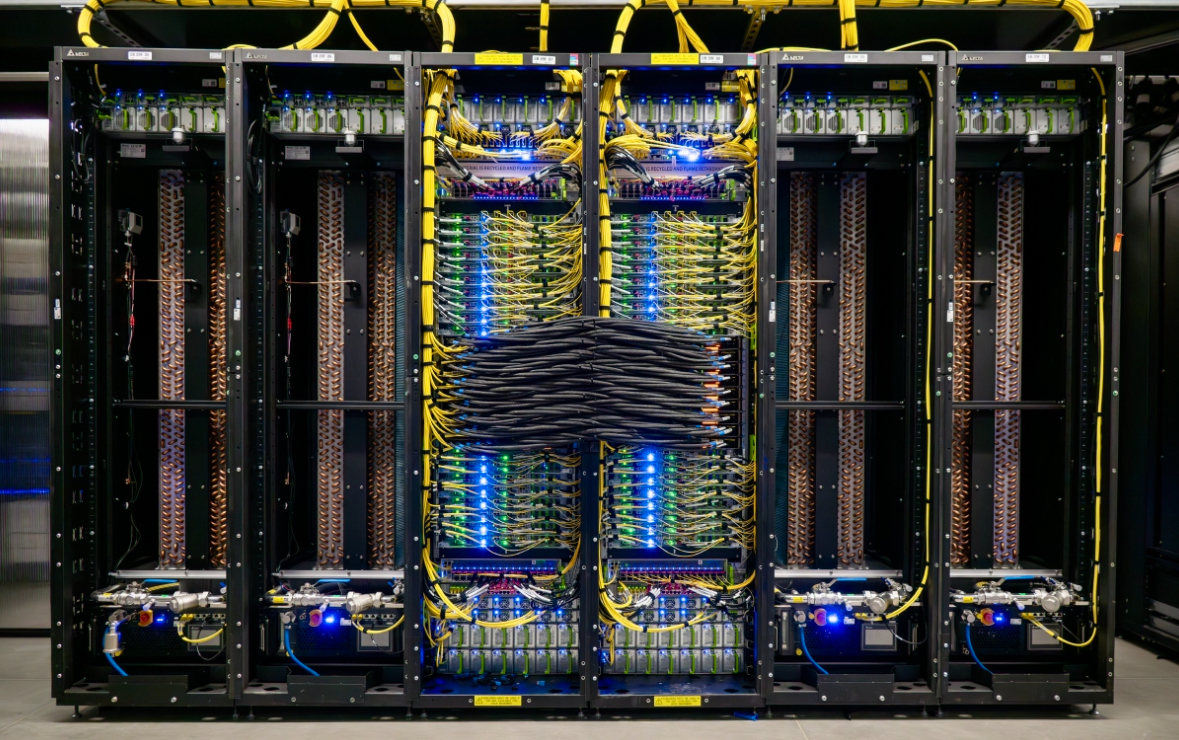
보도자료 내용에 따르면 사전학습 goodput은 85% 향상, 강화학습은 90% 향상을 기록했습니다. 평균 장애 간격(MTBI)은 약 4만7000 GPU시간에서 5만4000 GPU시간으로 늘어났습니다. 이 수치는 장애 복구와 재시작에 쓰이는 연산이 여전히 10~15% 수준으로 남아 있다는 뜻이기도 합니다.
학습 병목을 완전히 잡았다는 통념은 메타가 공시한 목표 미달 사실과 어긋납니다. 또한 이번 발표의 모든 수치는 메타 자체 보고이며, 2차 보도들도 전부 메타 블로그 단일 출처에 의존하고 있어 제3자 검증은 아직 이뤄지지 않았습니다.
엔비디아 투자자 관계 사이트의 보도자료(2026년 2월 17일)는 메타의 대규모 NVIDIA GPU 인프라 확장을 별도로 전했습니다. 메타 뉴스룸과 메타 리서치 블로그도 프로메테우스 1단계가 뮤즈 학습 인프라로 구성됨을 각각 확인했습니다. 인프라 규모 자체는 여러 1차 출처에서 일관되게 나타났습니다.
향후 관측 지점은 두 가지입니다. 목표치인 일 2건 장애와 10만 GPU시간 MTBI에 도달하는지, 그리고 이번 안정화가 일회성 개선인지 구조 전환인지는 몇 분기의 운영 데이터가 더 필요합니다. 종합하면 프로메테우스의 성능 향상 주장은 메타 자체 보고 범위 안에서 대체로 사실입니다.