AI · SEMICONDUCTOR · FACT CHECK
 SKD WIRE
메타가 10월 12일 신규 AI 모델 '뮤즈 원더'를 공개하며 선별 벤치마크에서 오픈AI·앤트로픽 모델을 상회하는 성적을 냈습니다. 다만 독립 평가에서 전체 최상위 모델을 넘어선 것으로 확인되지는 않았습니다.
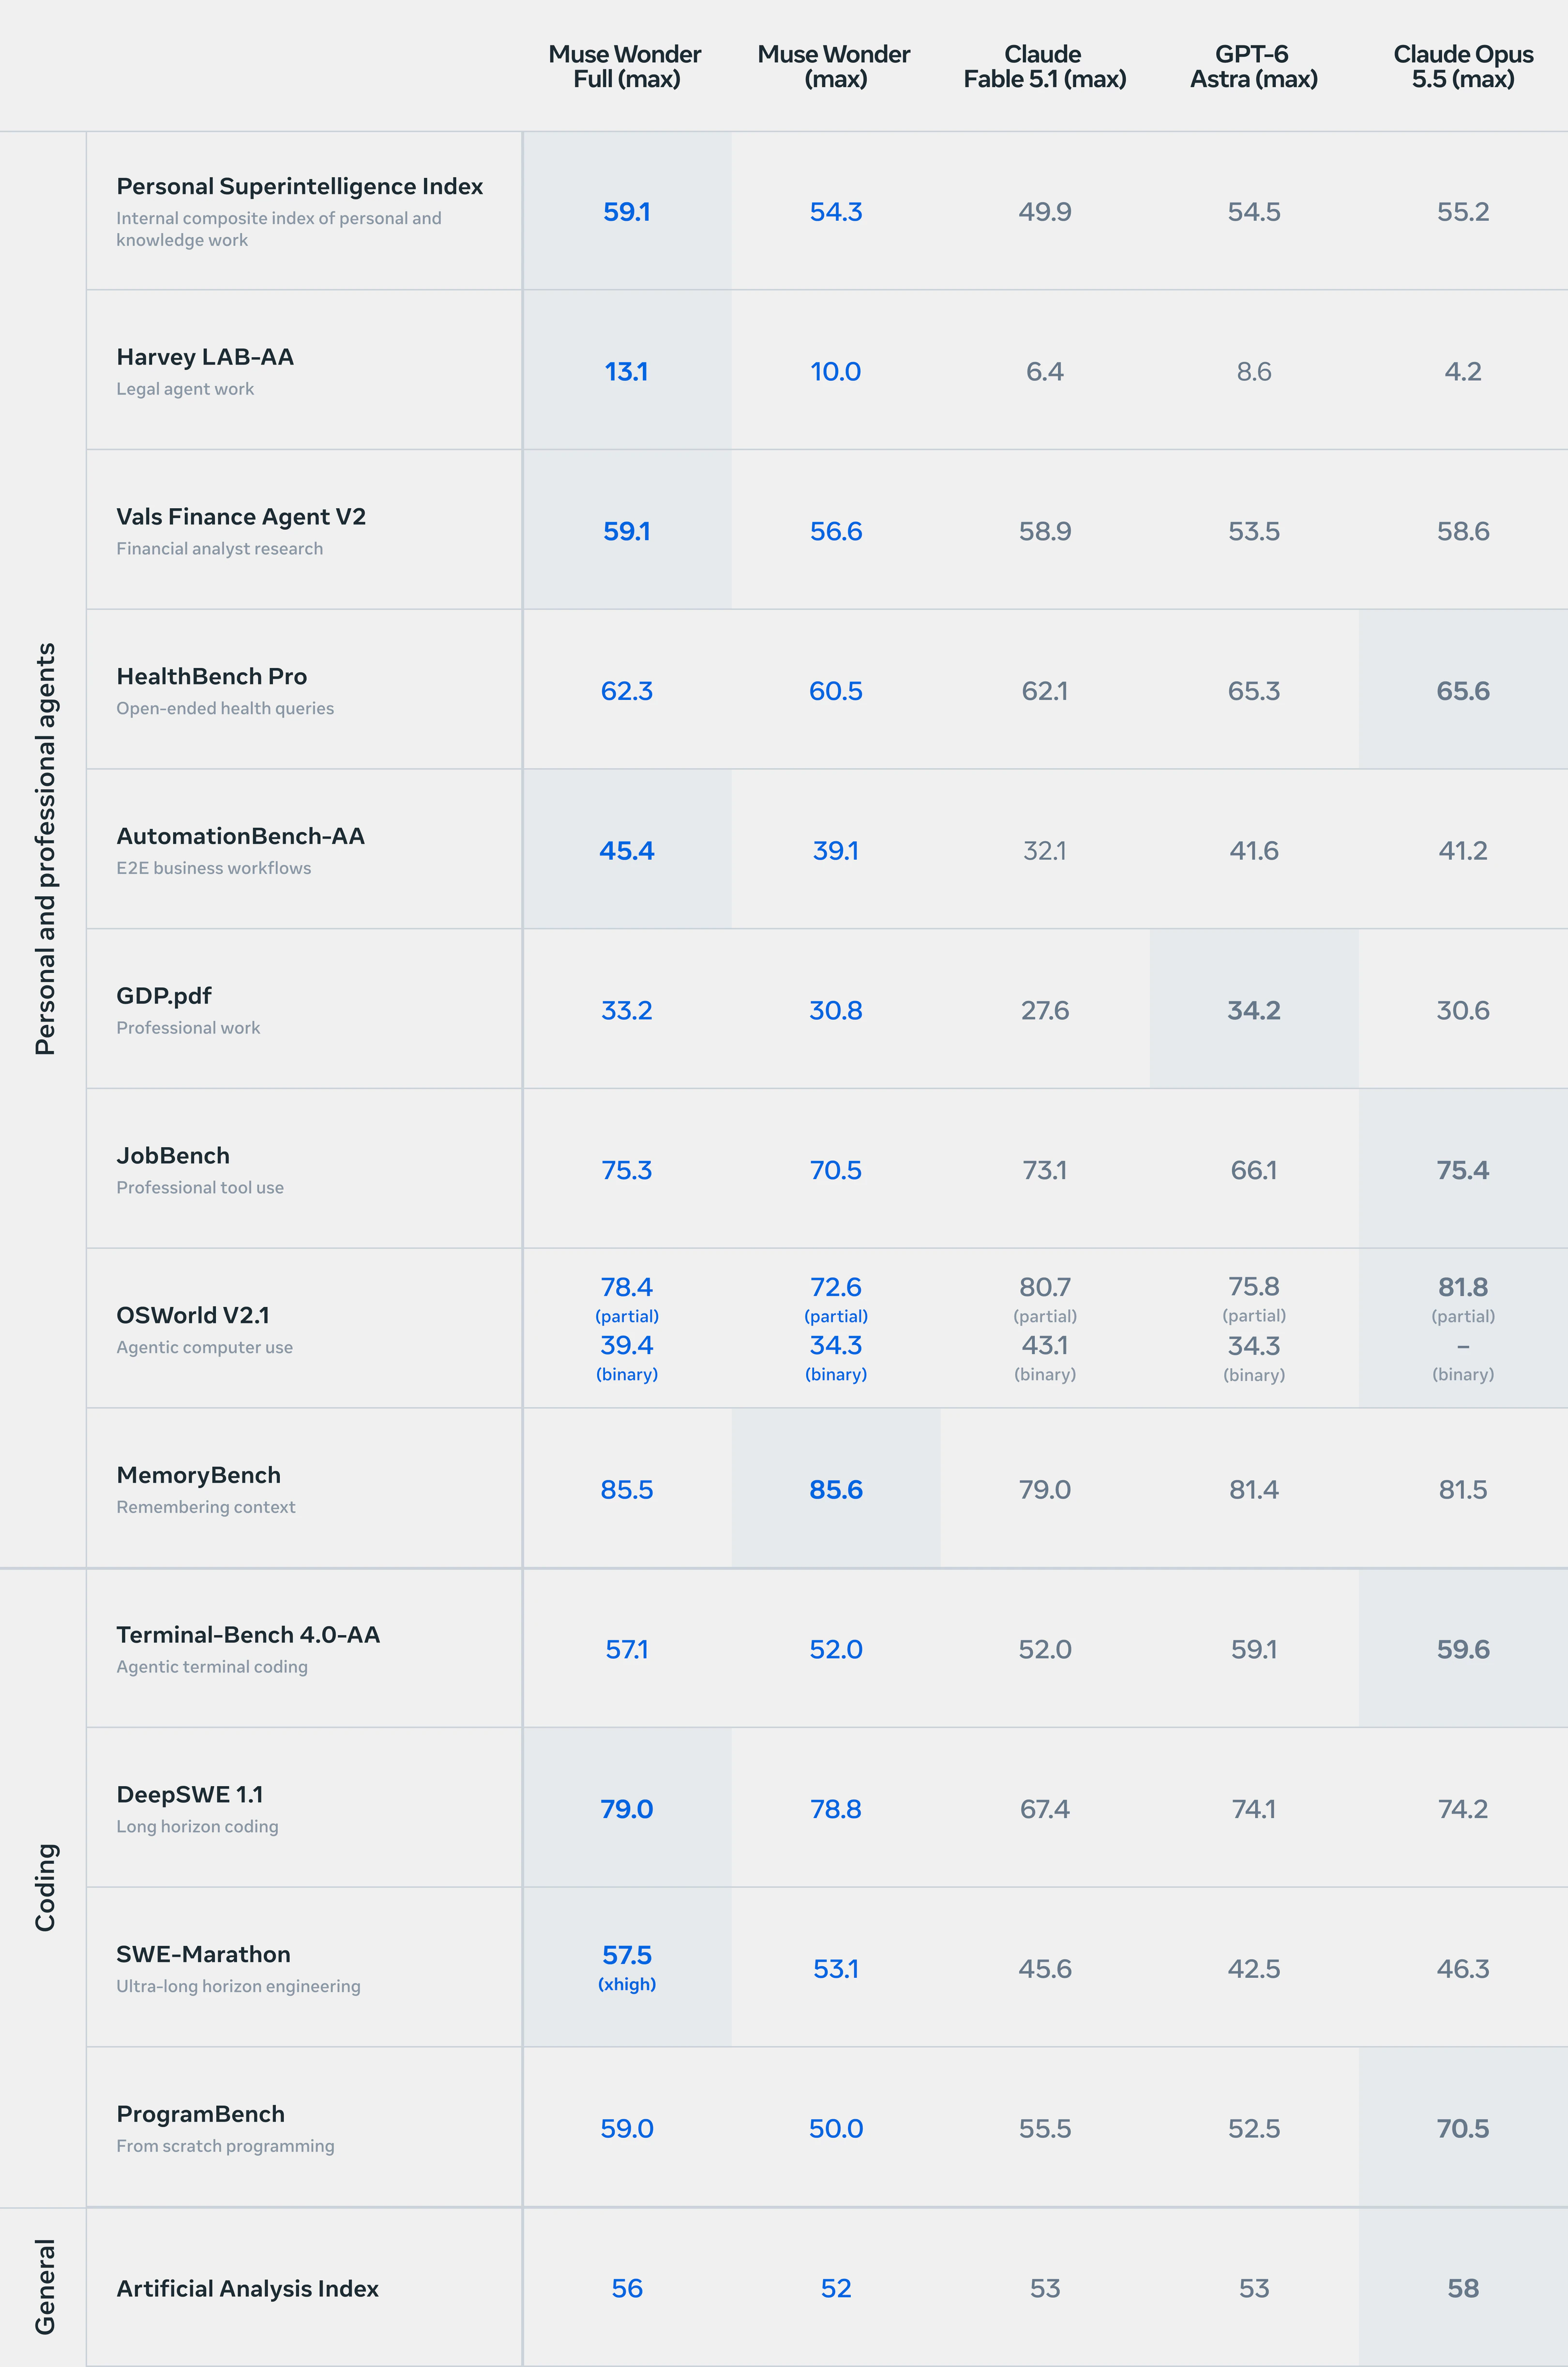
메타 발표에 따르면 변형 모델 원더 풀은 독립 평가기관 AAII에서 56점을 기록했고, 이는 오픈AI GPT-6 아스트라(53점)와 앤트로픽 클로드 페이블 5.1(53점)보다 높은 수치입니다. 메타는 코딩 영역에서 68점을 내며 클로드 코드+소닛 5.5 조합과 타이를 이뤘다고 밝혔습니다. 저커버그는 이 모델을 '진정한 최첨단'이라고 평가했습니다.
출처: 조사 출처
같은 AAII 지표에서 앤트로픽 최상위 모델 클로드 오퍼스 5.5는 58점을 기록하고 있어, 원더 풀 두 모델 모두 이보다 낮습니다. 기사 본문에 언급된 기본형 뮤즈 원더는 52점으로, 아스트라와 페이블 5.1의 53점보다 오히려 못 미칩니다. '오픈AI·앤트로픽 모델보다 우수'라는 헤드라인 문구는 전면 우월로 읽히지만, 실제 성적은 특정 변형이 비최상위 상대에 한해 일부 지표에서 앞선 것에 가깝습니다.
지식 영역에서는 격차가 뚜렷하게 어긋납니다. 뮤즈 계열의 AA-Omniscience 점수는 25~30점인 반면 경쟁 모델들은 42~46점을 기록했습니다. Vals AI 평가에서는 원더 풀이 오픈AI 전 모델을 상회한 대신, 앤트로픽 전 모델이 더 높게 나타났습니다. TechCrunch 요약 역시 메타 발표를 'comparable(대등한)' 수준으로 전했고, 메타 스스로도 전면 우월이 아닌 선별 영역의 최고 수준만 주장했습니다.
발표 직후 시점에서 독립 리더보드 측의 재현 데이터는 아직 확인되지 않았습니다. 이번 성적이 단발 벤치마크 이벤트인지 실사용 성능의 구조적 전환인지는 몇 분기의 관측이 더 필요합니다. 클로드 오퍼스 5.5와의 직접 비교 수치가 축적되는 시점에 이번 발표의 위치가 명확해질 것이며, 전체적으로는 '특정 변형이 특정 상대에 한해 일부 지표에서 우세하다'는 범위 안에서 부분 사실로 정리됩니다.