AI · SEMICONDUCTOR · FACT CHECK
 SKD WIRE
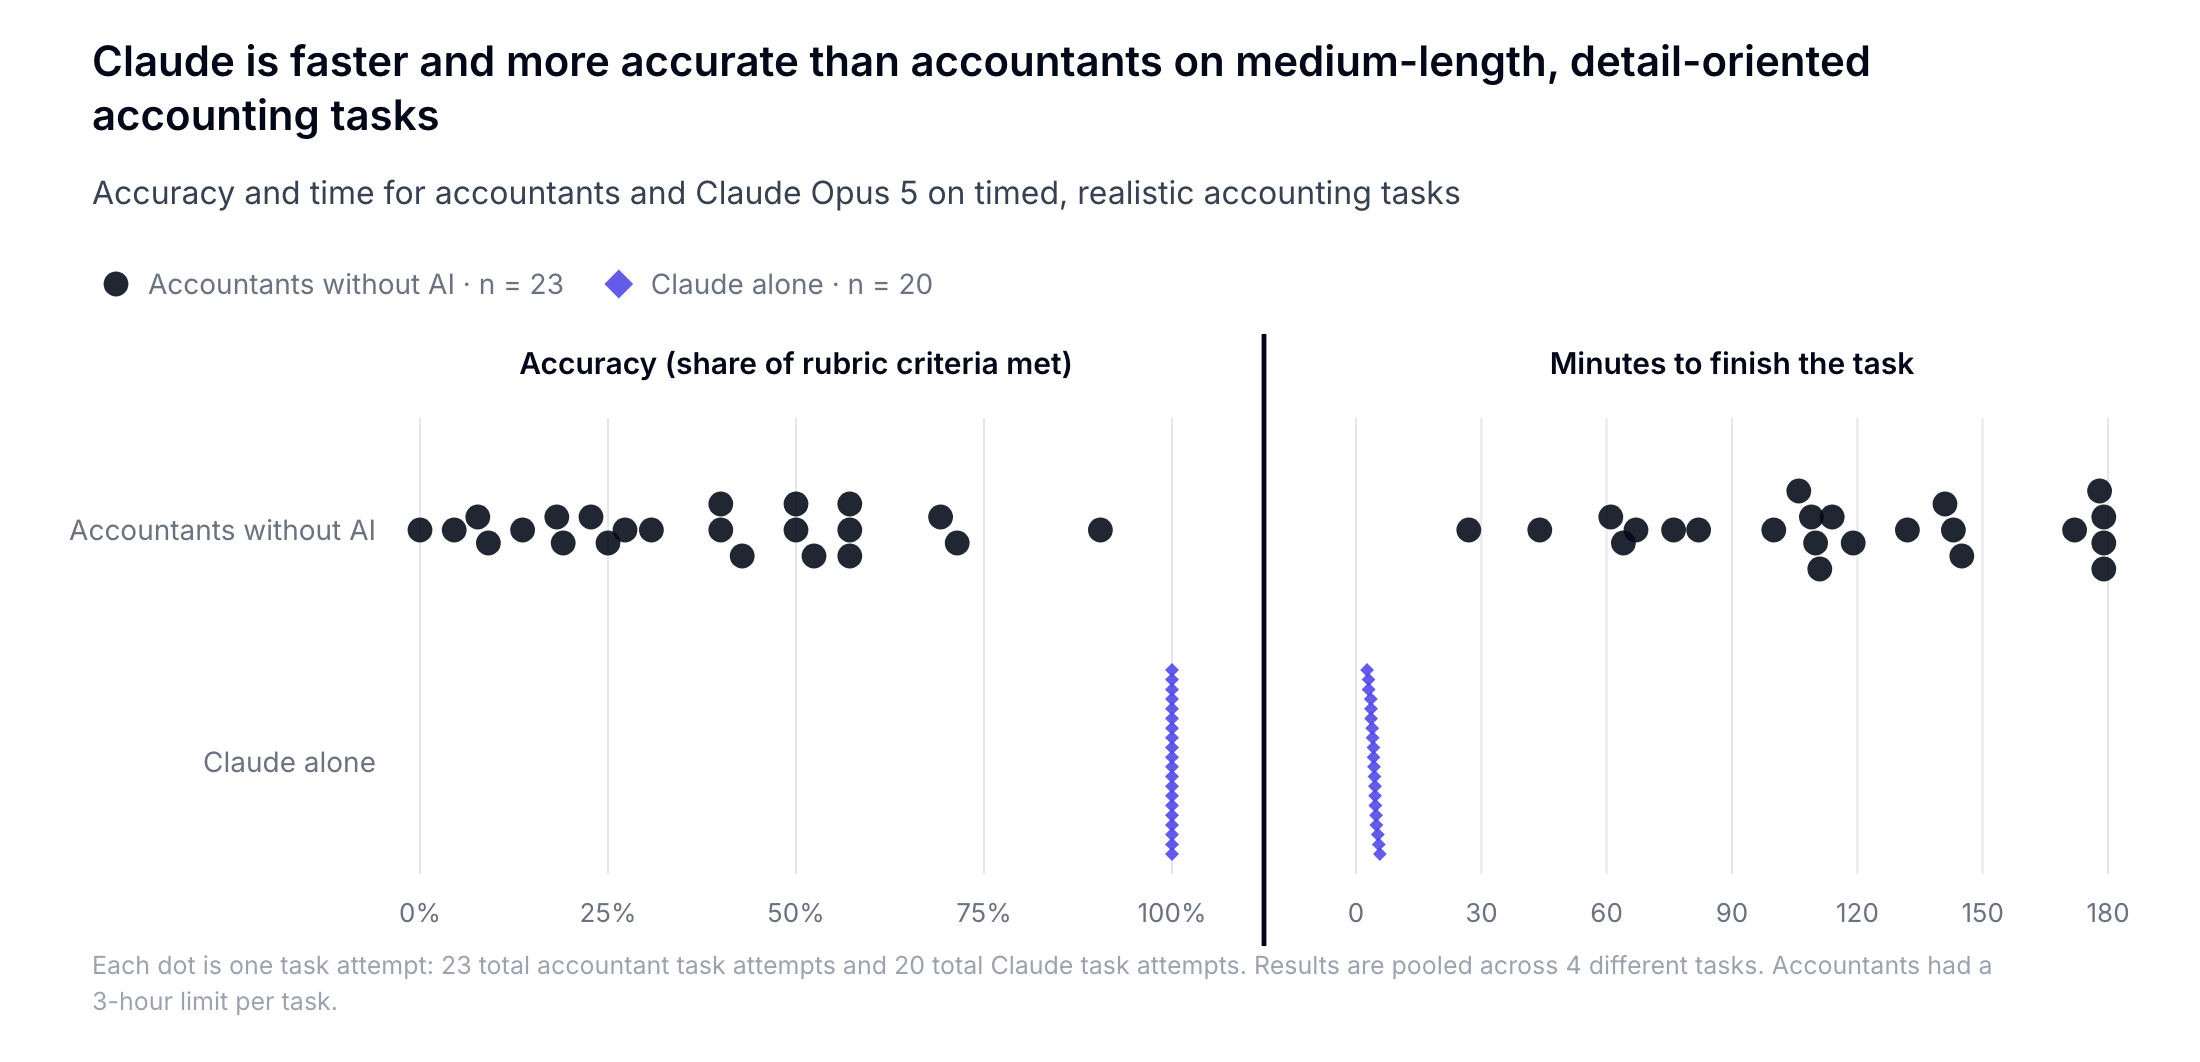
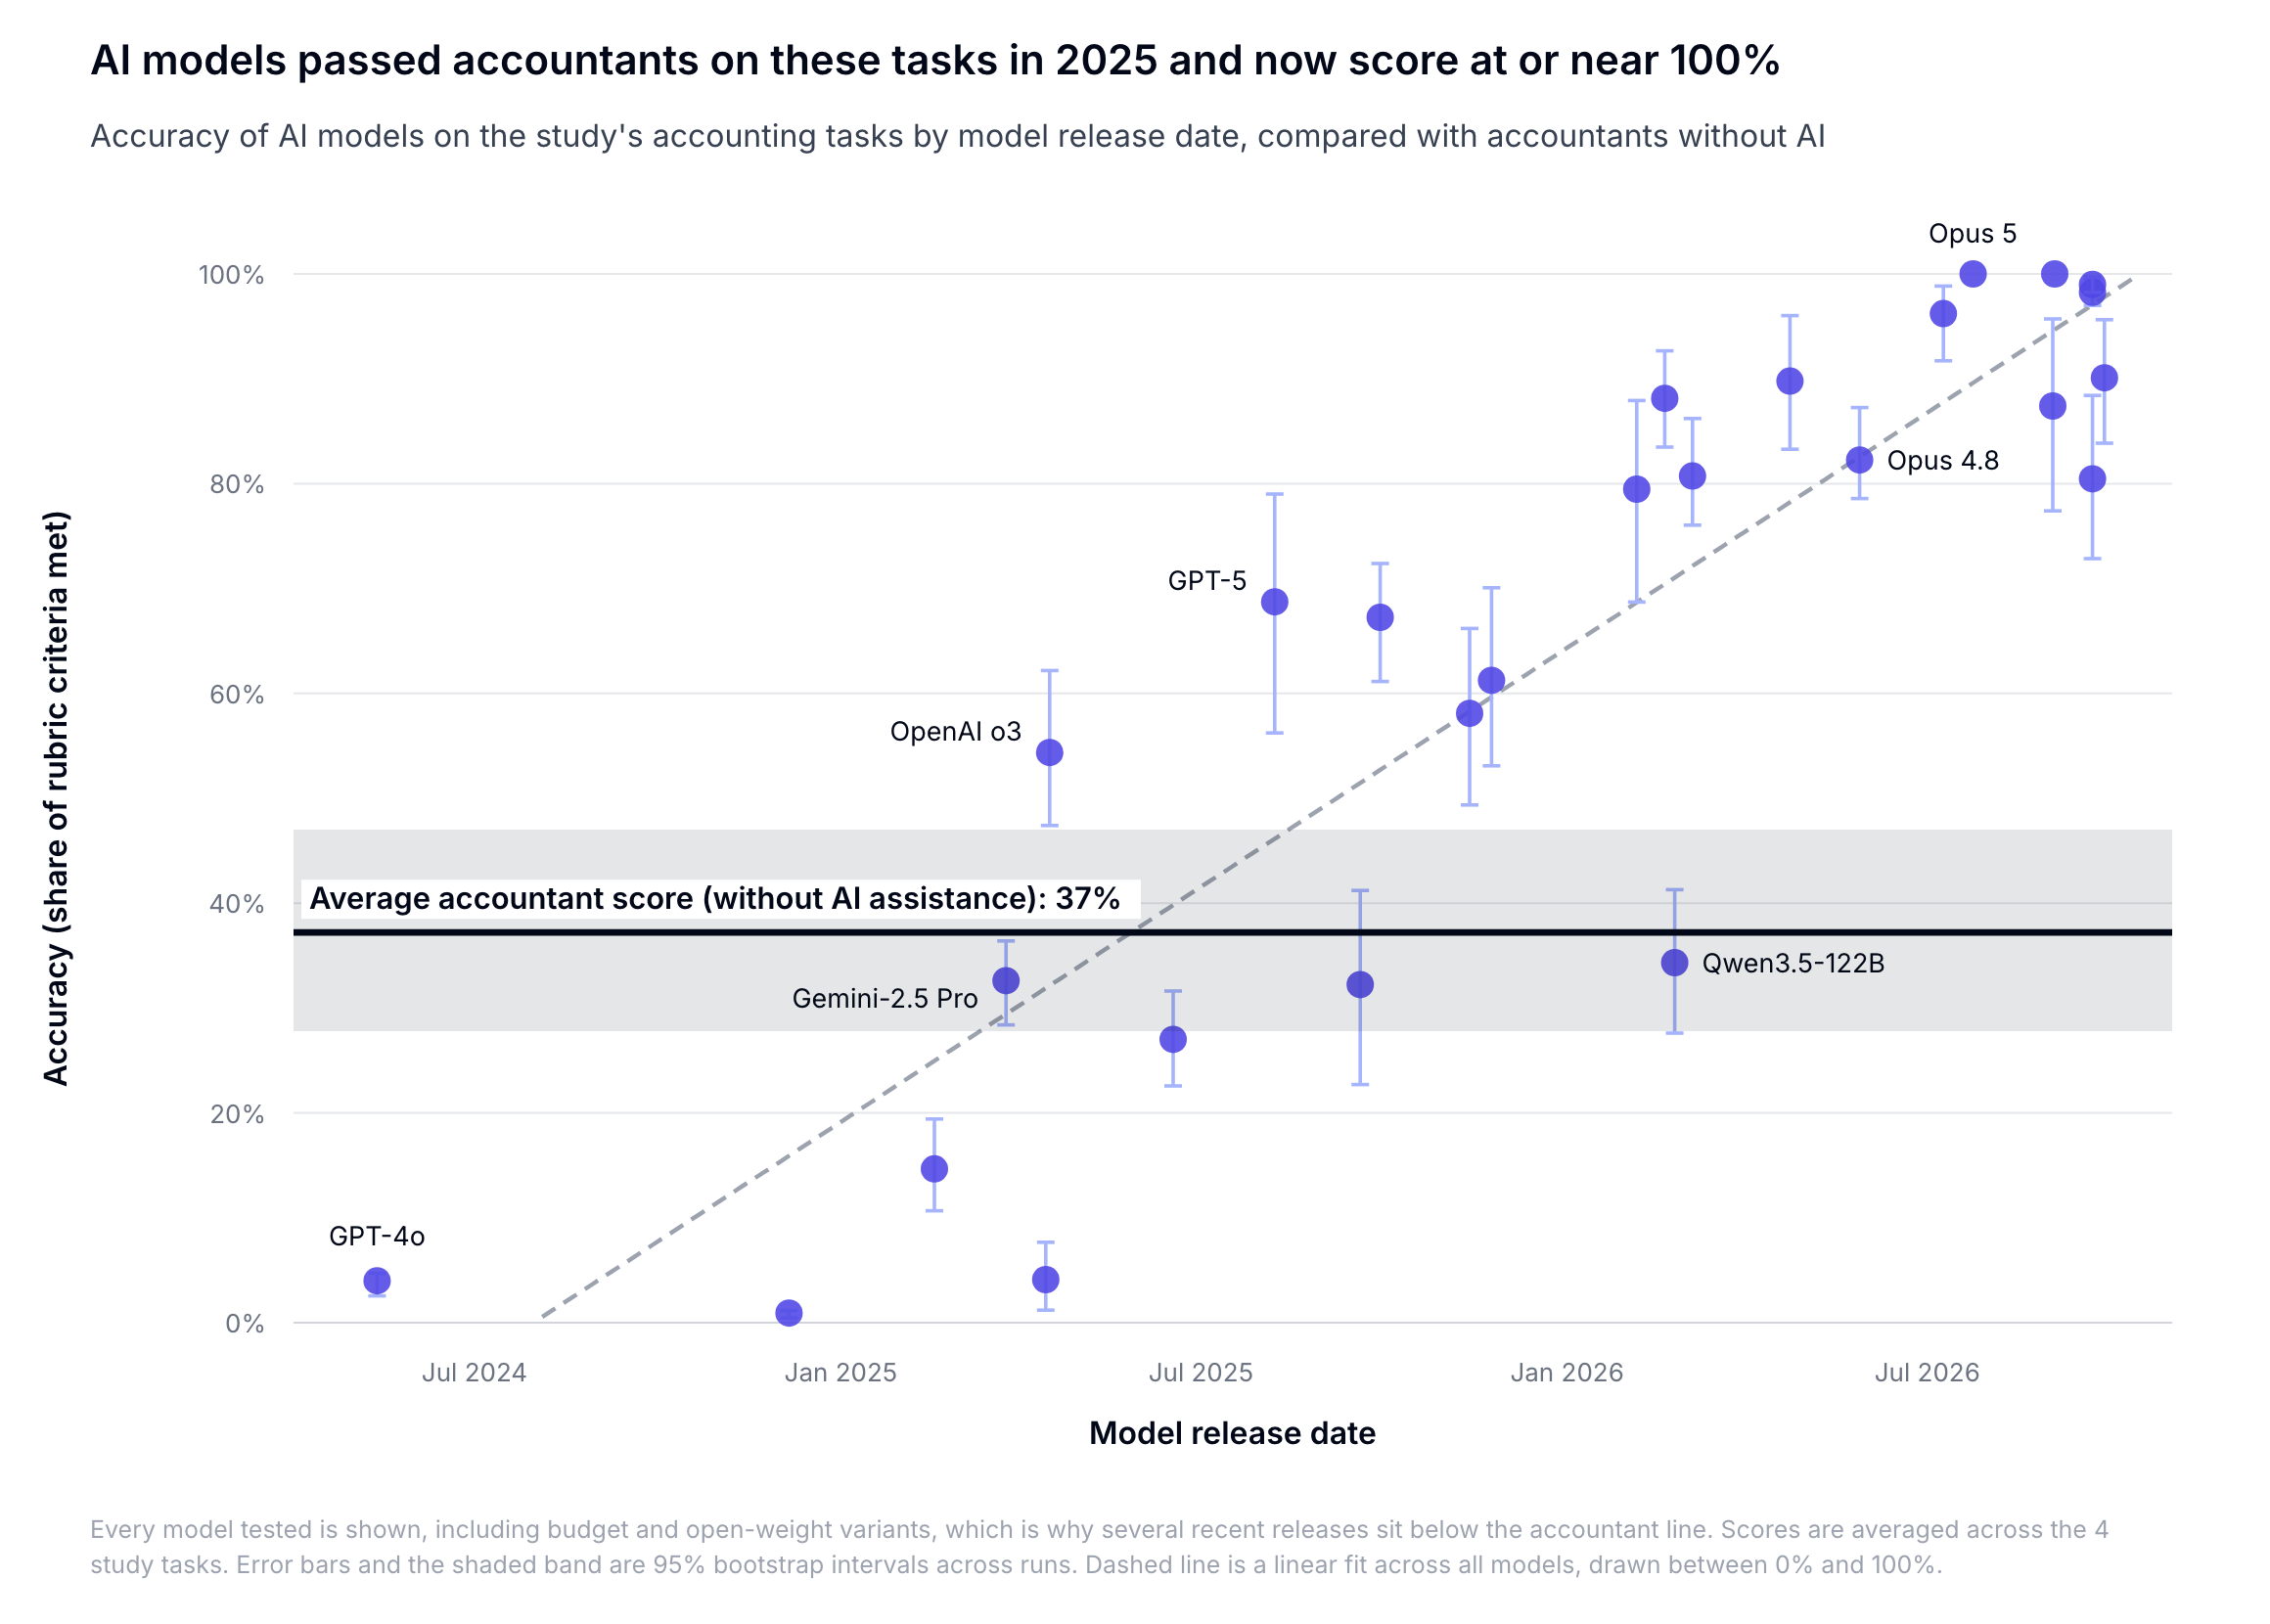
채용·인재평가 기업 Mercor가 10월 1일 회계 벤치마크 연구를 발표해 최신 AI 모델의 과제 완수율이 100%로, 숙련 인간 회계사의 37%보다 높게 나왔다고 밝혔습니다. AI가 인간 전문가를 100% 완수율로 추월한 것은 연구진이 언급한 역전 시점으로부터 18개월 만의 기록입니다.
발표문에 따르면 이번 연구는 숙련된 회계 전문가가 수행하는 월말 마감 업무를 재현한 과제들로 벤치마크를 구성했습니다. AI 모델은 과제를 100% 완수한 반면, 전문가 집단의 평균 완수율은 37%에 그쳤습니다. 비용 측면에서도 인간 대비 49배의 격차가 확인됐다고 연구진이 전했습니다. 18개월 전 인간이 우위를 유지하던 같은 과제군에서 모델이 역전에 성공한 것은 추론 성능 개선과 작업 구조의 단순화가 함께 작용한 결과로 풀이됩니다.
출처: 조사 출처
같은 논문의 전체 회계 벤치마크 성적은 이 그림과 어긋납니다. 최고 성능 모델의 전체 회계 과제 평균 점수는 61.8%에 불과했고, 58%의 과제는 어떤 모델도 해결하지 못한 것으로 기록됐습니다. '회계 업무에서 AI가 인간을 완벽히 앞섰다'는 통념은 단일 수치를 넘어 전 과제로 확대해 읽으면 성립하지 않는 셈입니다. 이번 범위 프레임의 한계는 관측이 더 필요한 부분으로 남습니다.
연구에서 AI가 100%를 기록한 영역은 구성된 과제 중 단순화된 월말 마감 과제 4개에 한정됐습니다. 실무 회계 전반의 판단·예외 처리 능력을 재는 시험이 아니라는 뜻입니다. CellCog의 2차 정리 자료 역시 이 연구가 해당 과제군 범위에서만 인간 기준선을 추월한 사례로 해석했습니다. 임상·법률 등 다른 전문 영역에 같은 결과를 일반화하는 것은 아직 확인되지 않았습니다.
Mercor는 이번 벤치마크를 자사 리더보드의 회계 부문으로 공개해 기업들이 모델을 비교할 수 있게 했다고 밝혔습니다. 다만 초급 회계사의 업무를 대상으로 한 단일 벤치마크 결과를 전 직급 대체 가능성으로 읽는 확장은 논문 자체가 뒷받침하지 않습니다. 월말 마감과 같은 정형 과제에서의 성능이 실제 기업 환경의 비정형 변수를 다루는 수준인지는 몇 분기의 관측이 더 필요합니다. 이번 발표는 정형 회계 과제 한정에서 AI가 인간 기준선을 명확히 추월했음을 보여준 결과로, 전체 회계 실무 기준으로는 대체로 사실이라는 범위 안에서 받아들일 점이 있습니다.