오픈AI 아스트라의 99.9%는 진짜지만 '인간 vs AI 판별 시험'이라는 명칭은 어디에도 없었다
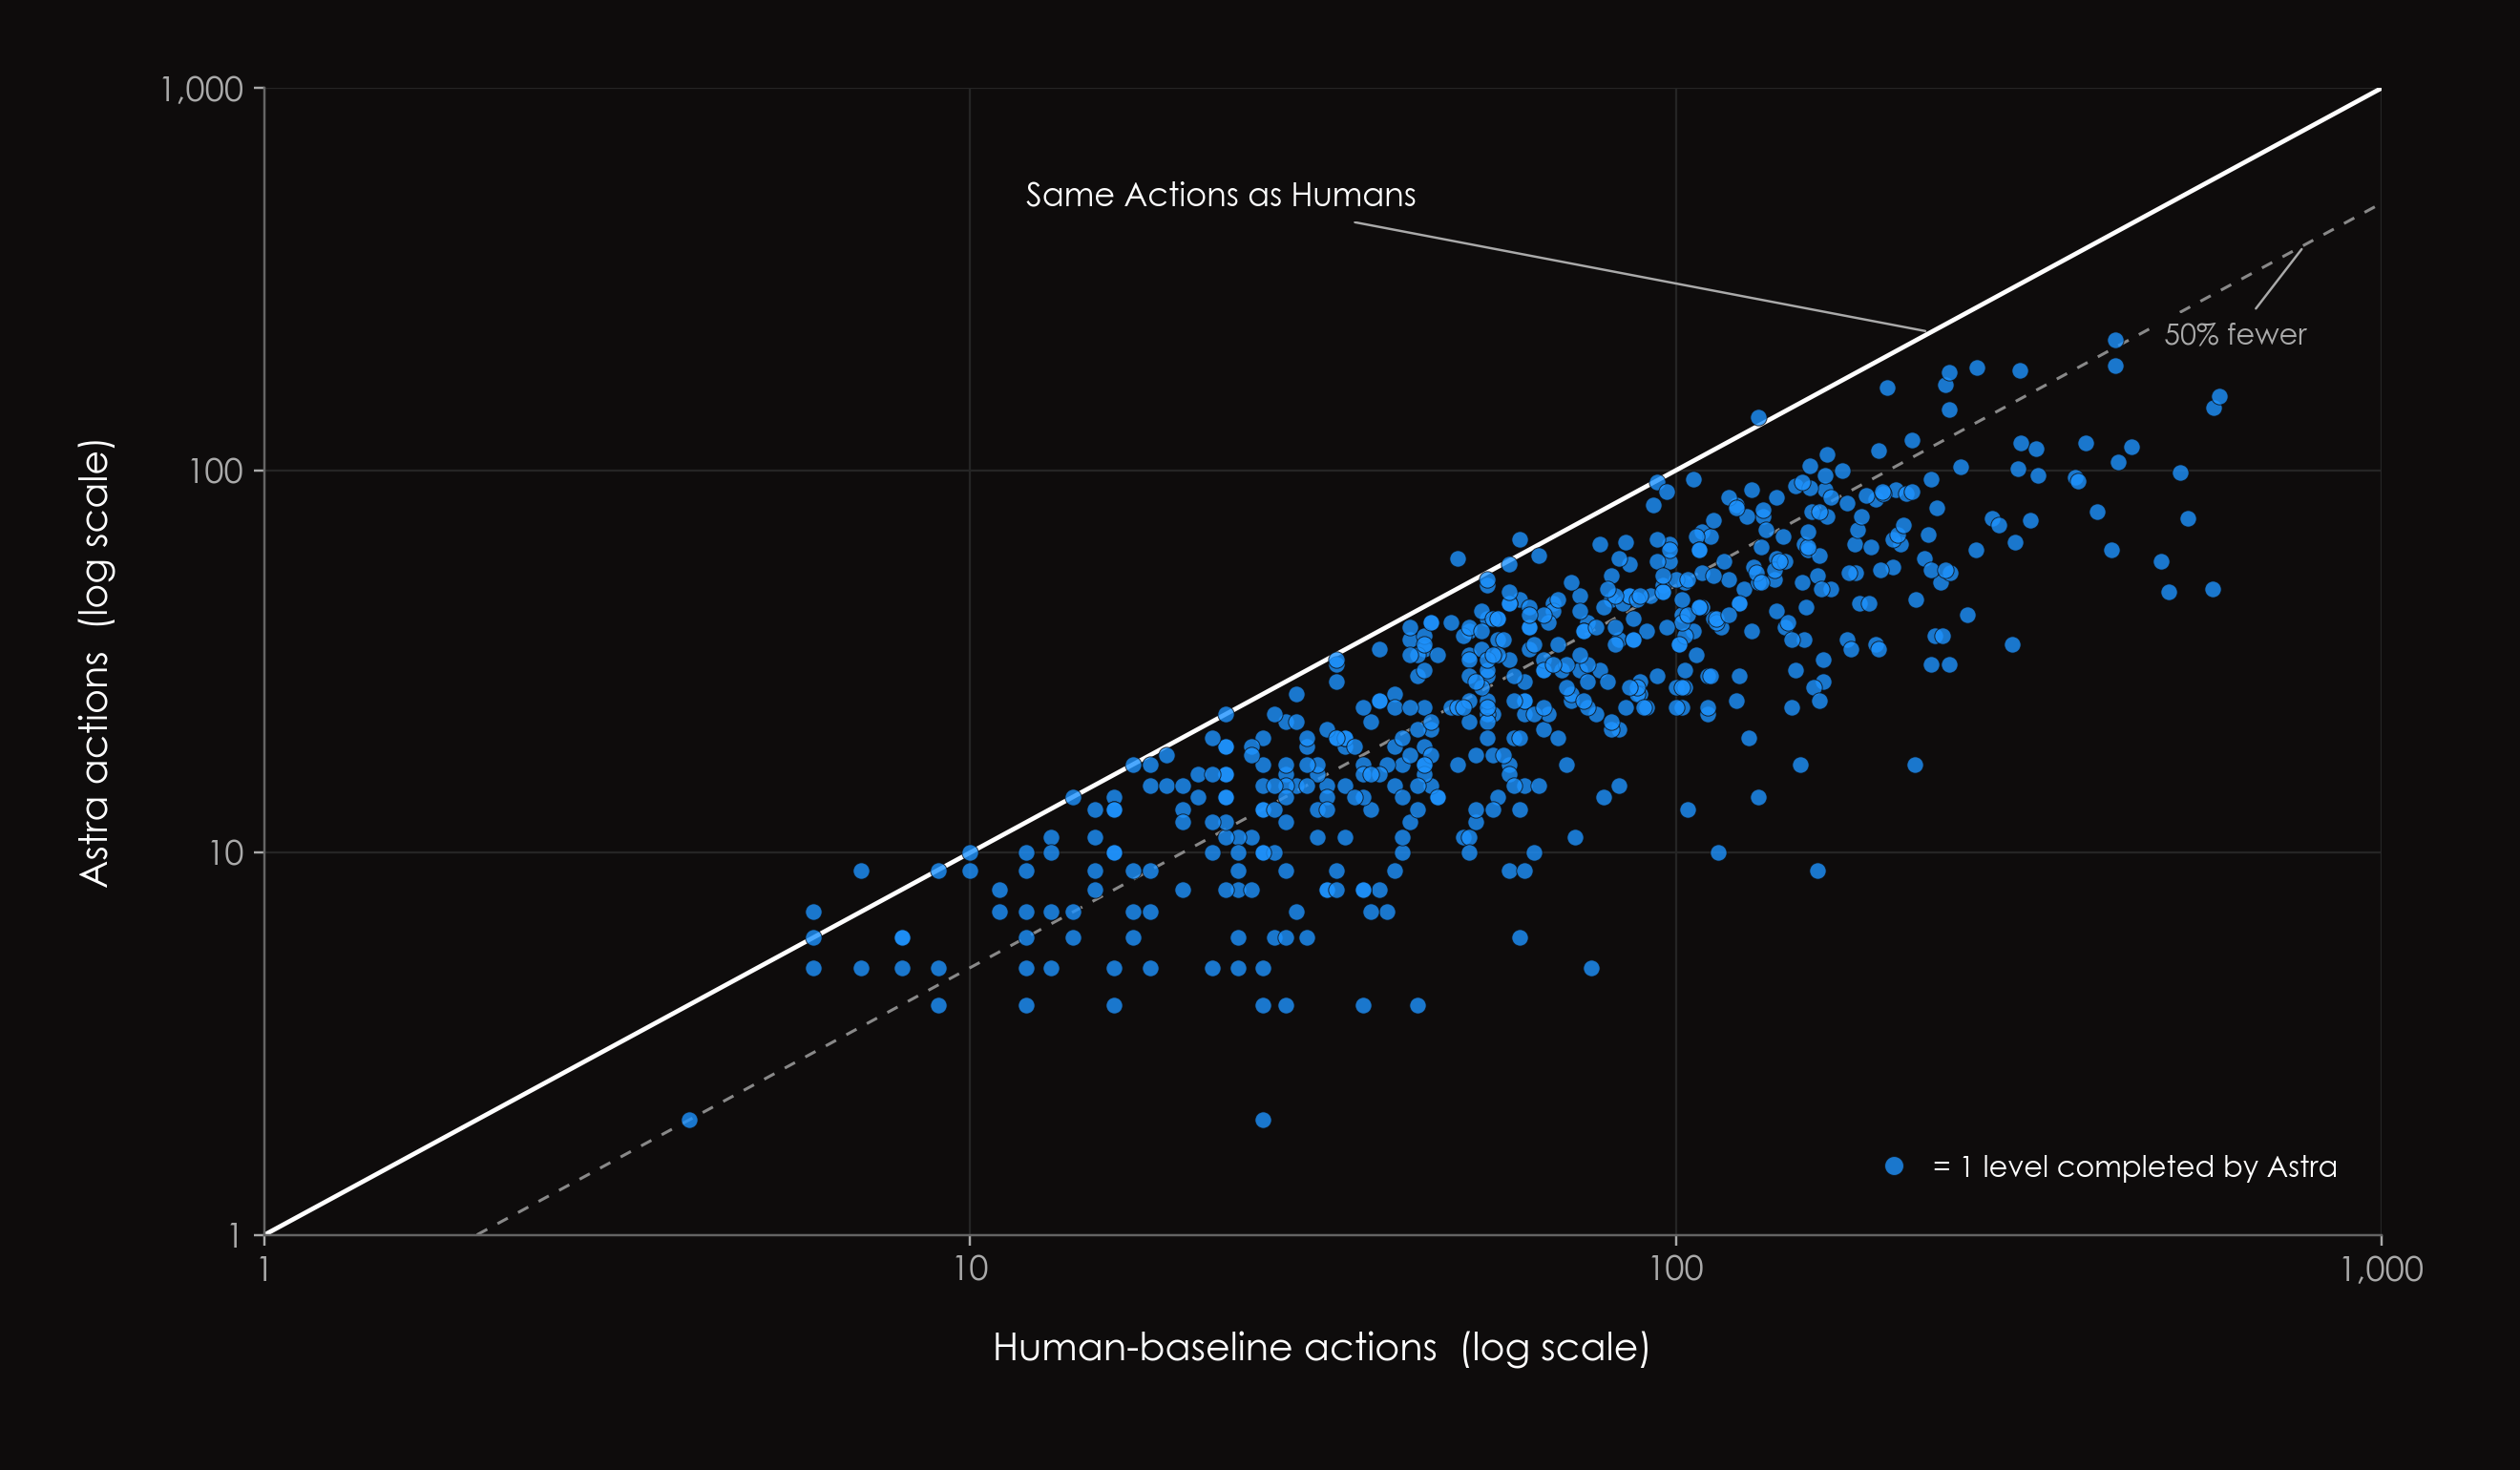
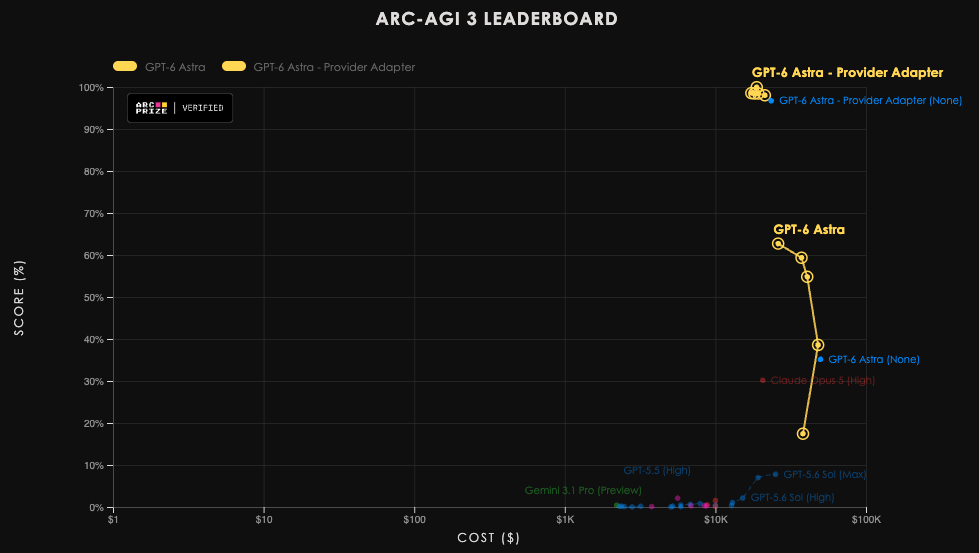
99.9%라는 숫자의 출처는 ARC-AGI-3 리더보드
arcprize.org의 results 페이지(openai-gpt-6-astra)는 아스트라의 성적을 공식 게시했다. 발표문에 따르면 ARC-AGI-3는 인간이 100% 풀어낼 수 있는 인터랙티브 추론 과제로 구성된 벤치마크다. 리더보드는 인간 기준선과 AI 모델의 성능을 나란히 비교하는 방식으로 운영된다.
'인간 vs AI 판별 시험'이라는 문구는 공식 명칭이 아니었다
출처: 조사 출처
arcprize.org, openai.com 등 1차 출처 어디에도 '인간 vs AI 판별 시험'이라는 명칭은 등장하지 않았다. 이 시험의 실체는 인간과 AI를 판별하는 도구가 아니라 인간 기준선 대비 모델 성능을 측정하는 추론 벤치마크다. 해당 문구의 원 출처는 국내 검색 경로 차단으로 아직 확인되지 않았다.
하네스에 따라 37.2%포인트 차이가 난 점수
Provider Adapter 하네스의 99.9%와 표준 하네스의 62.7%는 측정 환경 차이만으로 37.2%포인트 벌어져 있다. arcprize.org는 하네스별 점수를 구분해 게시했으며 이는 동일 모델이라도 평가 조건에 따라 결과가 달라짐을 보여준다.
확립된 사실과 확인되지 않은 부분
점수 자체와 벤치마크의 성격은 1차 출처에서 모두 확립됐다. 시험의 공식 명칭을 왜곡한 '인간 vs AI 판별 시험' 문구의 유통 경로는 확인되지 않았다. 아스트라가 99.9%를 기록한 것은 사실이지만 시험의 성격을 판별 시험으로 설명한 부분은 사실이 아니어서 종합적으로 부분 사실이다.
오픈AI와 ARC 프라이즈의 후속 발표에서 표준 하네스 기준 점수의 추가 갱신 여부를 지켜볼 필요가 있다. 국내 유통된 '인간 vs AI 판별 시험' 문구의 최초 출처도 향후 확인 대상이다.