구글 리서치, AI 검색 쿼리 팬아웃 지연 최대 20배 낮춘 R4T 프레임워크 공개
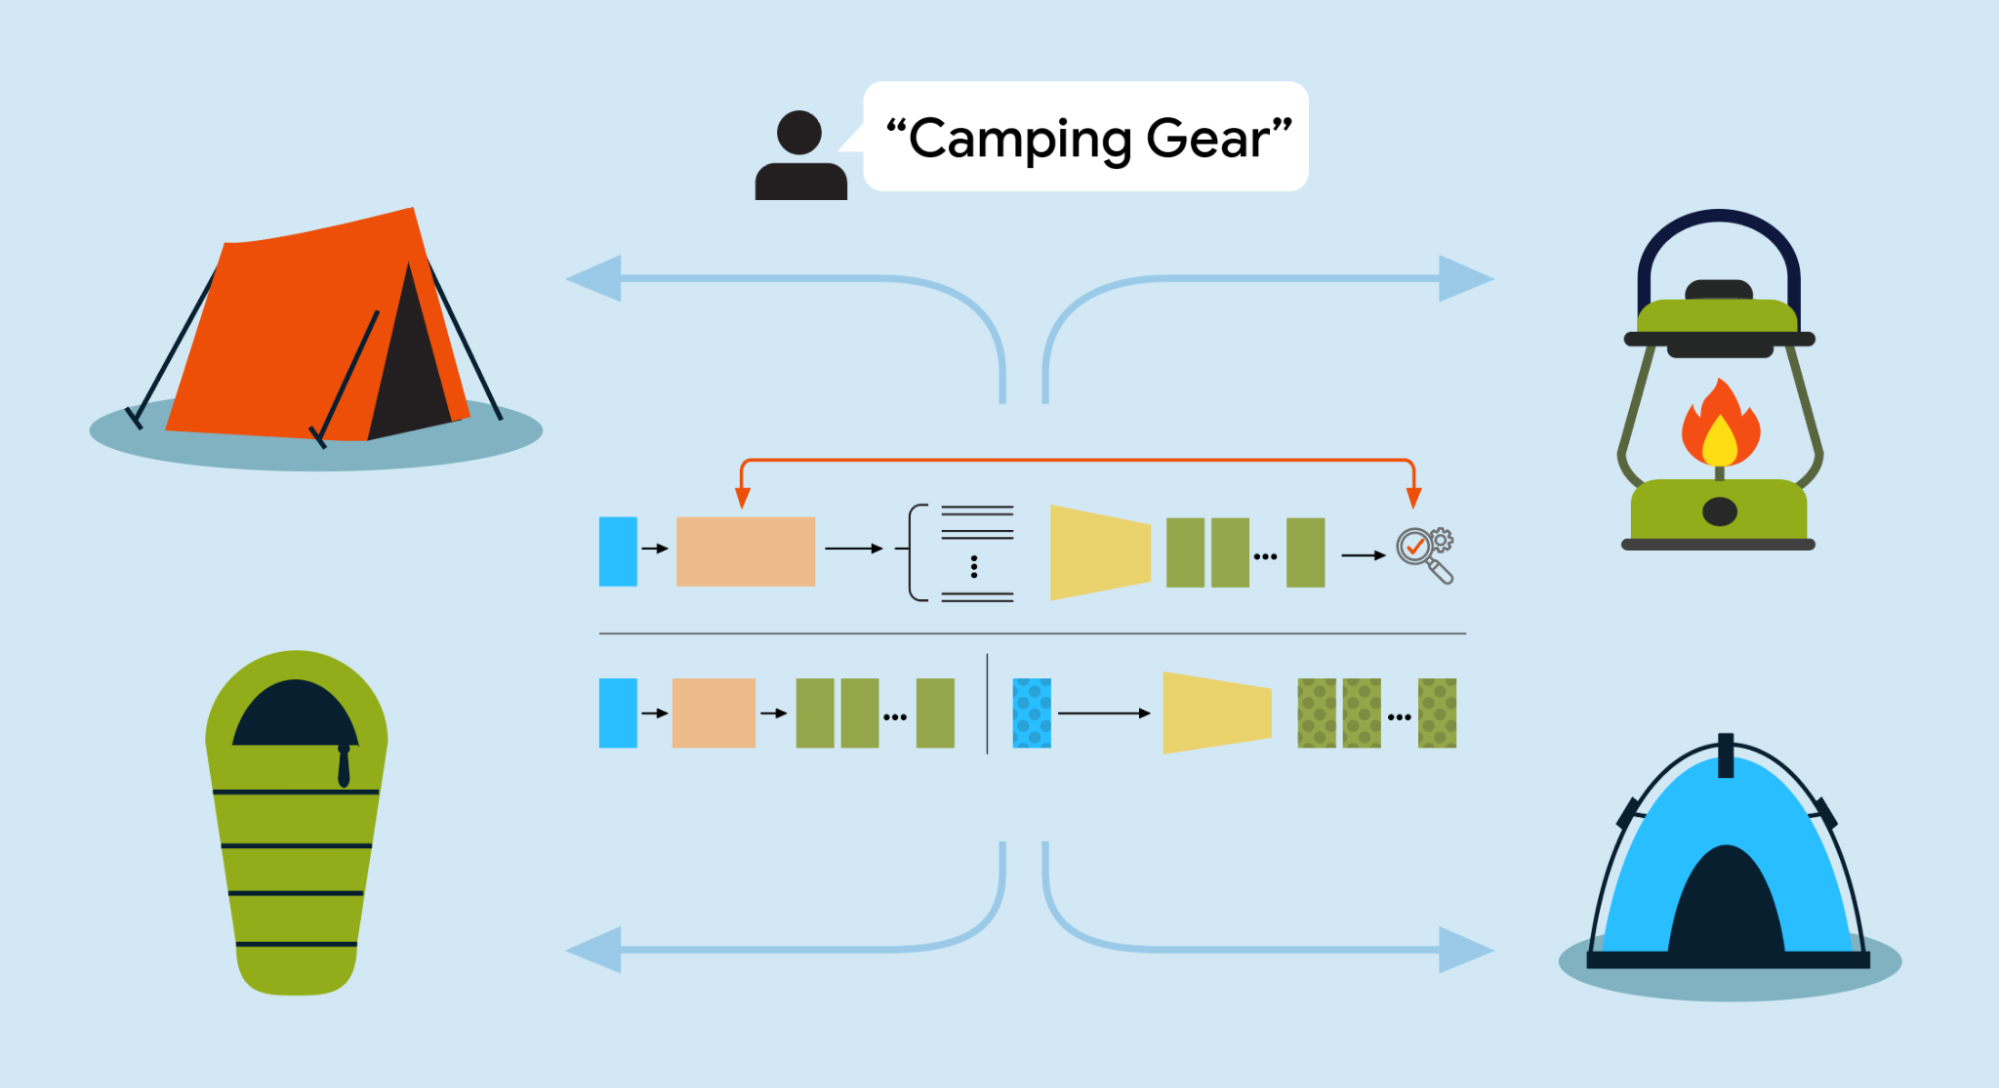
구글 리서치가 AI 검색 쿼리 팬아웃 지연을 언어모델 대비 최대 20배 낮춘 프레임워크 R4T를 9월 15일 공개했습니다. 수치는 벤치마크 결과로서 검색 서비스 전체 속도 향상을 뜻하지는 않습니다.
쿼리 팬아웃 병목을 겨냥한 R4T 구조
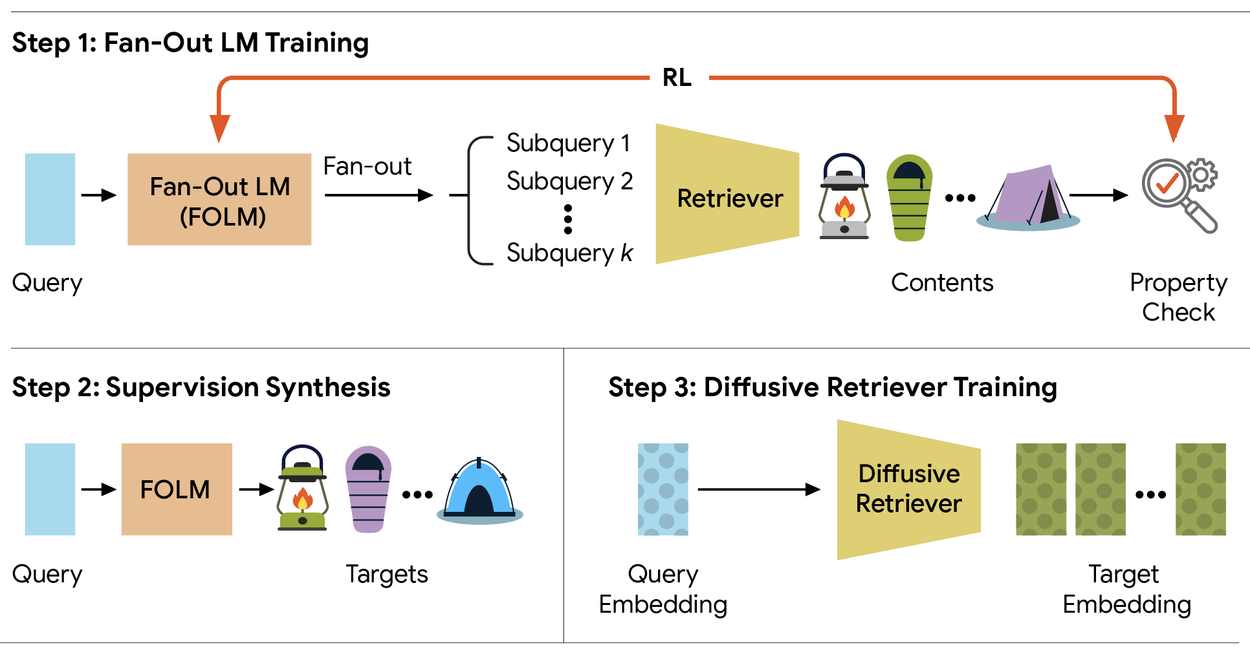
발표문에 따르면 R4T는 Retrieve for Train의 줄임말입니다. 구글은 이를 복합 AI 검색 전반의 추론 병목을 우회하는 수단으로 소개했습니다. 블로그 제목에는 ‘추론 병목 우회’와 ‘복합 AI 검색 가속’이라는 문구가 담겼습니다.
쿼리 팬아웃은 복합 질의 하나를 여러 갈래 세부 검색으로 펼치는 단계입니다. R4T가 최적화 대상으로 삼은 것은 바로 이 단계에서 걸리는 지연 시간입니다.
최대 20배는 벤치마크 지연 비교 수치
논문에 따르면 20배는 쿼리 팬아웃 단계 지연을 자기회귀 언어모델 베이스라인과 비교한 값입니다. MarkTechPost 등 해외 기술 매체는 12배에서 20배 빨라진 것으로 보도했습니다. 이 수치는 구글 검색 서비스 전체가 20배 빨라진다는 의미로 읽으면 안 됩니다. 구글 스스로도 이번 발표를 제품 출시가 아닌 연구 프레임워크 소개로 표현했습니다.
출처: 조사 출처
국내에서는 AI타임스가 ‘AI 검색 속도 최대 20배’라는 제목으로 이 발표를 전했습니다. 제목의 ‘AI 검색 속도’는 벤치마크 항목으로 한정해 읽는 편이 정확합니다.
논문과 ICML 게재로 교차 확인된 발표
검증팀은 구글 리서치 블로그 HTML과 arXiv 논문 소스 파일을 내려받아 수치를 대조했습니다. 접근이 차단된 AI타임스 원문은 별도 수집 경로로 확보한 뒤 대조했습니다. 논문이 실린 ICML 2026 공식 게재 목록도 검증 대상에 포함시켰습니다.
arXiv 메타데이터에 따르면 논문 2603.06397의 초판은 3월 6일에 공개됐습니다. 구글 리서치 블로그의 공식 발표 글은 그로부터 약 반년 뒤인 9월 15일에 올라왔습니다. 논문 공개와 블로그 발표의 시점 차이는 순서 문제일 뿐 상호 모순은 아닙니다. 논문 공동 연구진 가운데는 일리노이대(UIUC) 소속 인원이 포함돼 있습니다. ‘구글 연구진 발표’라는 귀속은 대학 공동 연구 구성에서도 성립합니다. 블로그와 논문, ICML 2026 목록 세 자료는 서로 모순 없이 일치했습니다.
아직 확인되지 않은 제품화와 외부 반응
발표문에 따르면 구글은 출시 일정이나 적용 서비스를 별도로 밝히지 않았습니다. R4T가 실제 구글 검색 서비스에 반영될지는 아직 확인되지 않았습니다. 이 프레임워크에 대한 독립적 반론이나 비판 보도도 아직 확인되지 않았습니다. 다만 논문은 ICML 2026에 게재돼 학계 검증의 일부를 통과한 상태입니다.
남은 관심사는 이 벤치마크 성과가 실제 검색 서비스 성능으로 이어지는가입니다. 향후 확인할 지점은 제품 반영 여부와 독립 연구진의 재현 평가입니다. 구글이 적용 계획을 밝히기 전까지는 20배 수치를 쿼리 팬아웃 벤치마크로 한정해 읽어야 합니다. 쿼리 팬아웃 벤치마크라는 전제를 적용하면 이번 발표의 핵심 주장은 사실입니다.