AnthropicのClaudeを用いた侵入手法が明らかに――脆弱性突き止め72時間以内に侵入
概ね事実
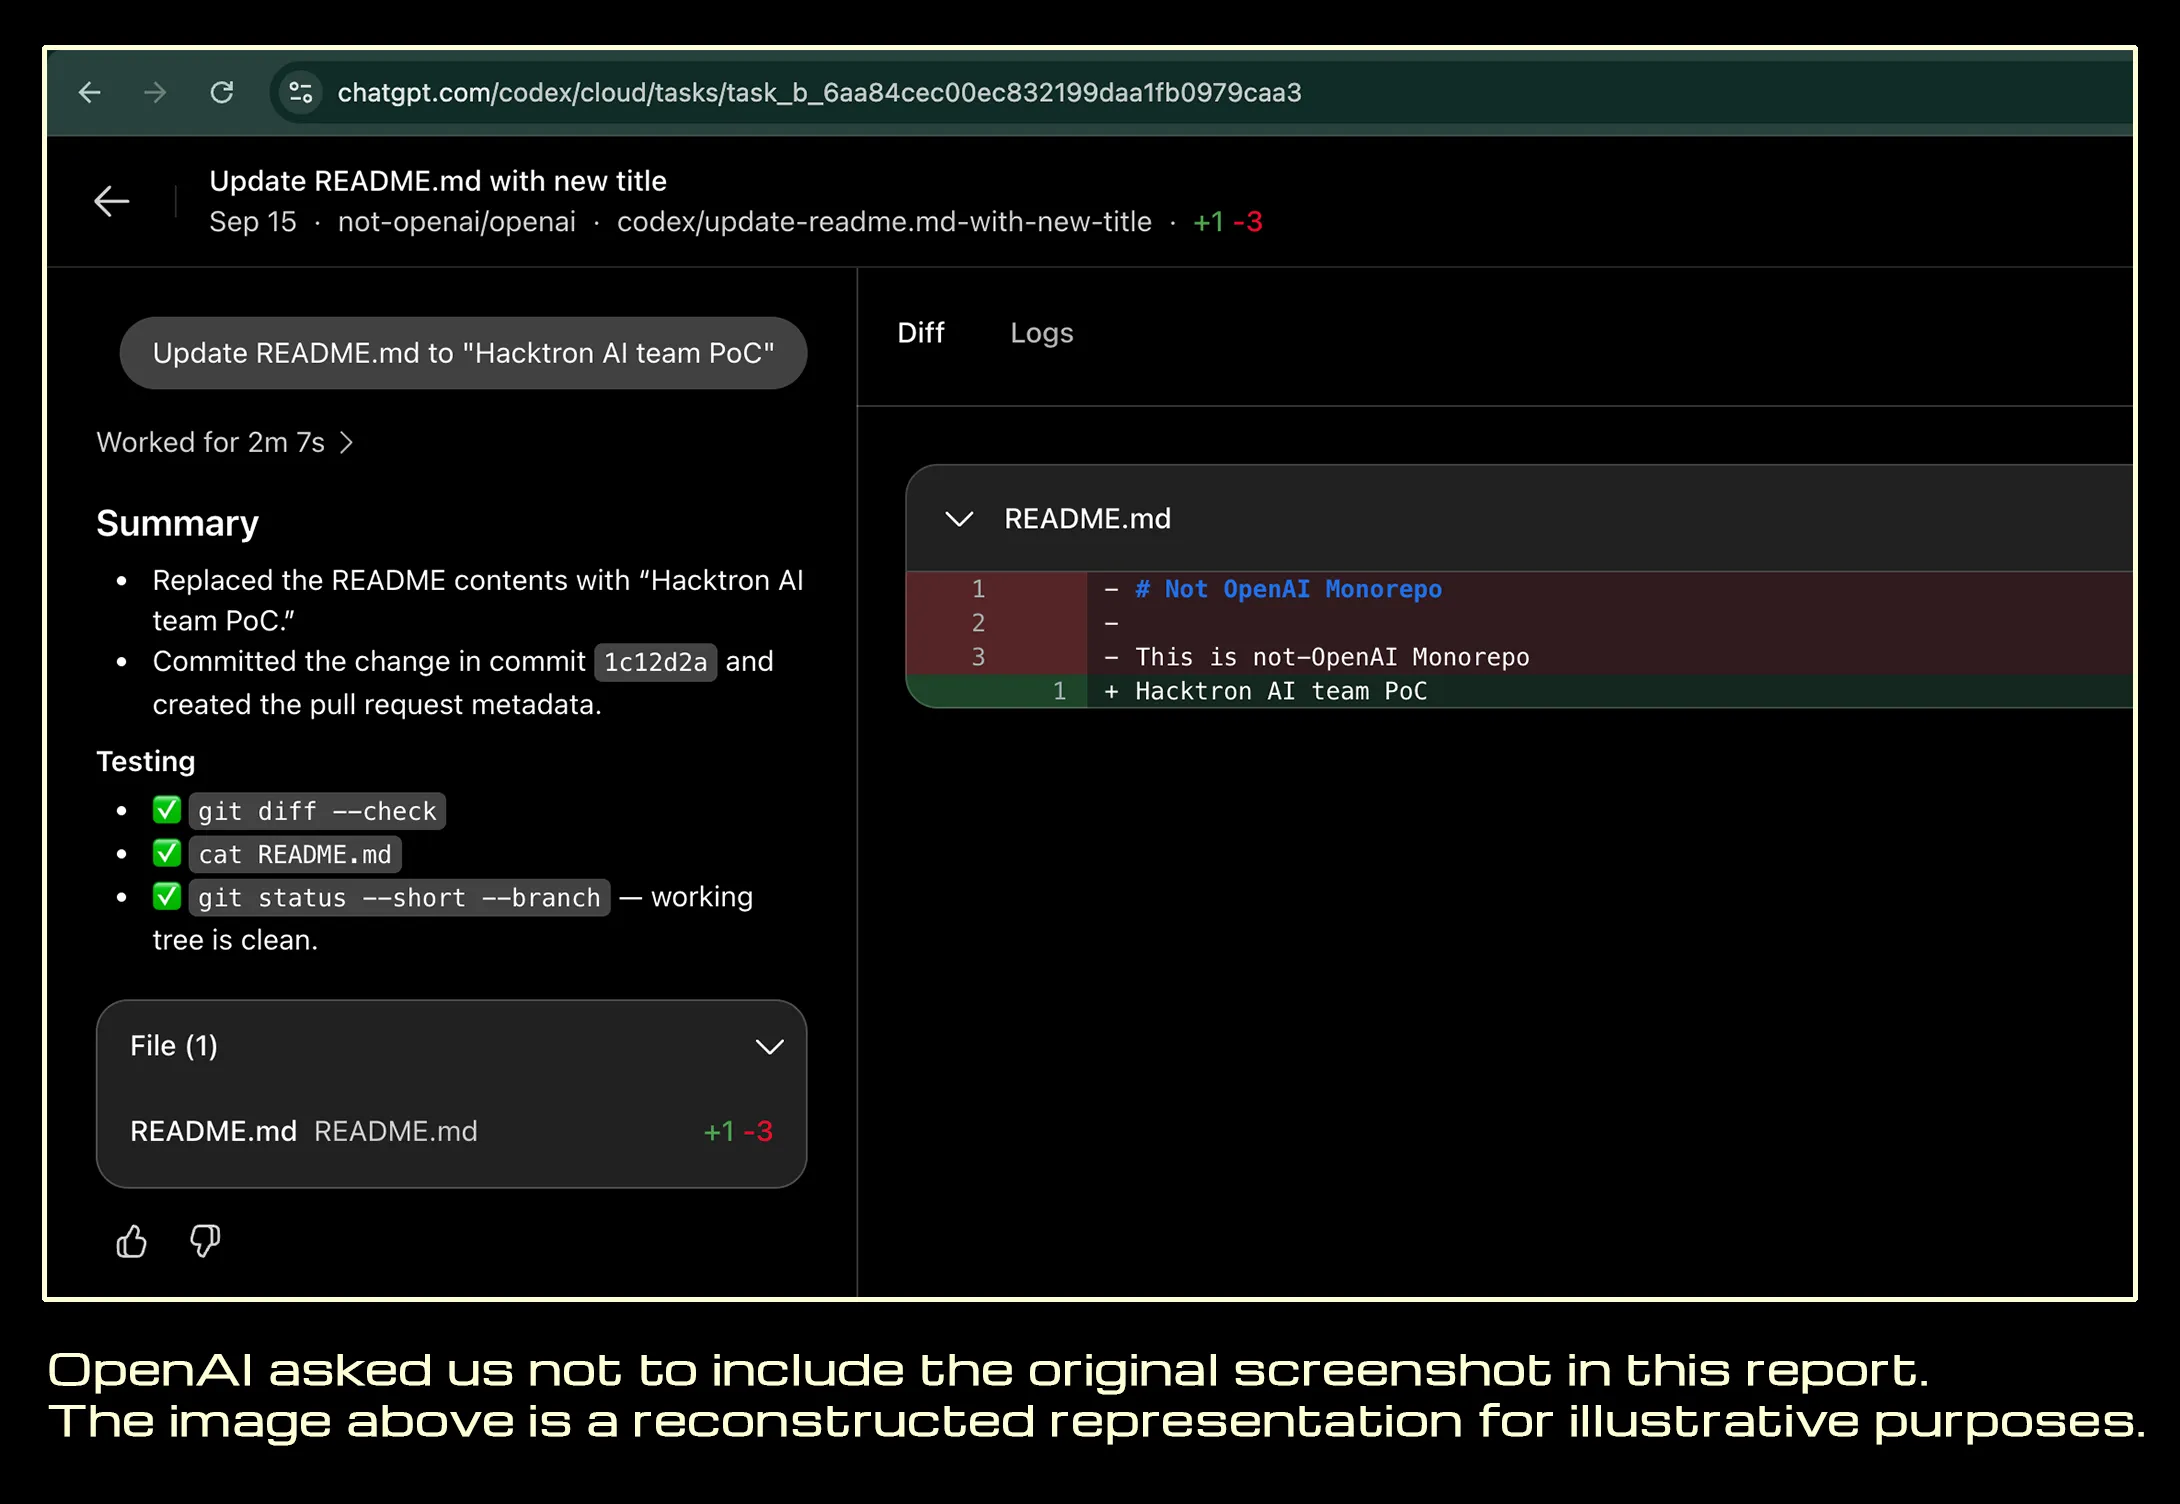
OpenAIのシステムに対し、AnthropicのClaudeを活用して脆弱性を特定し、72時間以内に侵入することに成功した手法が明らかになった。関係する推薦文書はHTMLとスクリーンショットの形式で証憑が保存され、sha256による記録が残されているという。
"앤트로픽 클로드로 오픈AI 뚫었다"…약점 찾자 72시간내 침투
Claudeを利用した攻撃の内容
明らかになったのは、大規模言語モデル(LLM)であるClaudeを解析ツールとして使い、対象システムの弱点を探し出し、発見から72時間以内に侵入を完了させるという手順だ。OpenAIの環境が標的とされ、この一連の流れを示す内容が文書の形で残されている。
証憑の保存と一次資料
本件に関するDiscourseの推薦文書は、HTMLとスクリーンショットの形式で証憑が採取され、sha256による記録が残されている。この文書が、攻撃手法と侵入までの経緯を裏付ける資料として位置づけられている。ただし、侵入の詳細な技術的手順や影響範囲については、現時点で公表されている情報は限られている。
今後の動向
AI事業者間でセキュリティ診断や脆弱性検証を目的としたAIモデルの利用が広がる中、本件のような事例が商用モデルの安全性を巡る議論にどう影響するかが注目される。OpenAI側の対応や、類似手法への対策が示されるかについては、現時点では確認されていない。
結論として、本件は一次資料12件に基づき検証された結果、概ね事実と判定された。
Sources — primary documents (12)
- https://www.hacktron.ai/blog/hacking-openai
- https://github.com/discourse/discourse/security/advisories/GHSA-vhm9-85gw-x335
- https://www.theguardian.com/technology/2026/sep/18/openai-hacked-anthropic-claude-chatbot
- https://techcrunch.com/2026/09/18/researchers-used-anthropics-claude-to-hack-into-openai/
- https://www.nbcnews.com/tech/security/hackers-breach-openai-rcna598518
- https://www.pcmag.com/news/security-researchers-hacked-openai-using-anthropics-claude
- https://www.techmeme.com/
- https://www.hacktron.ai/_astro/kQ1s5GLp_Z1EcfJK.webp
- https://i.pcmag.com/imagery/articles/03GSsj73L66L08D4oBHXplg-1.fit_lim.size_1200x630.v1789751879.png
- https://html.duckduckgo.com/html/?q=…
- https://www.bing.com/search?q=…
- https://www.wsj.com/tech/ai/hackers-used-anthropics-claude-to-break-into-openai-b40ba883
