Anthropic के Claude से OpenAI की सुरक्षा भेदी गई — कमजोरी खोजने वाला AI 72 घंटे में सेंध लगाने में सफल
ज़्यादातर सही
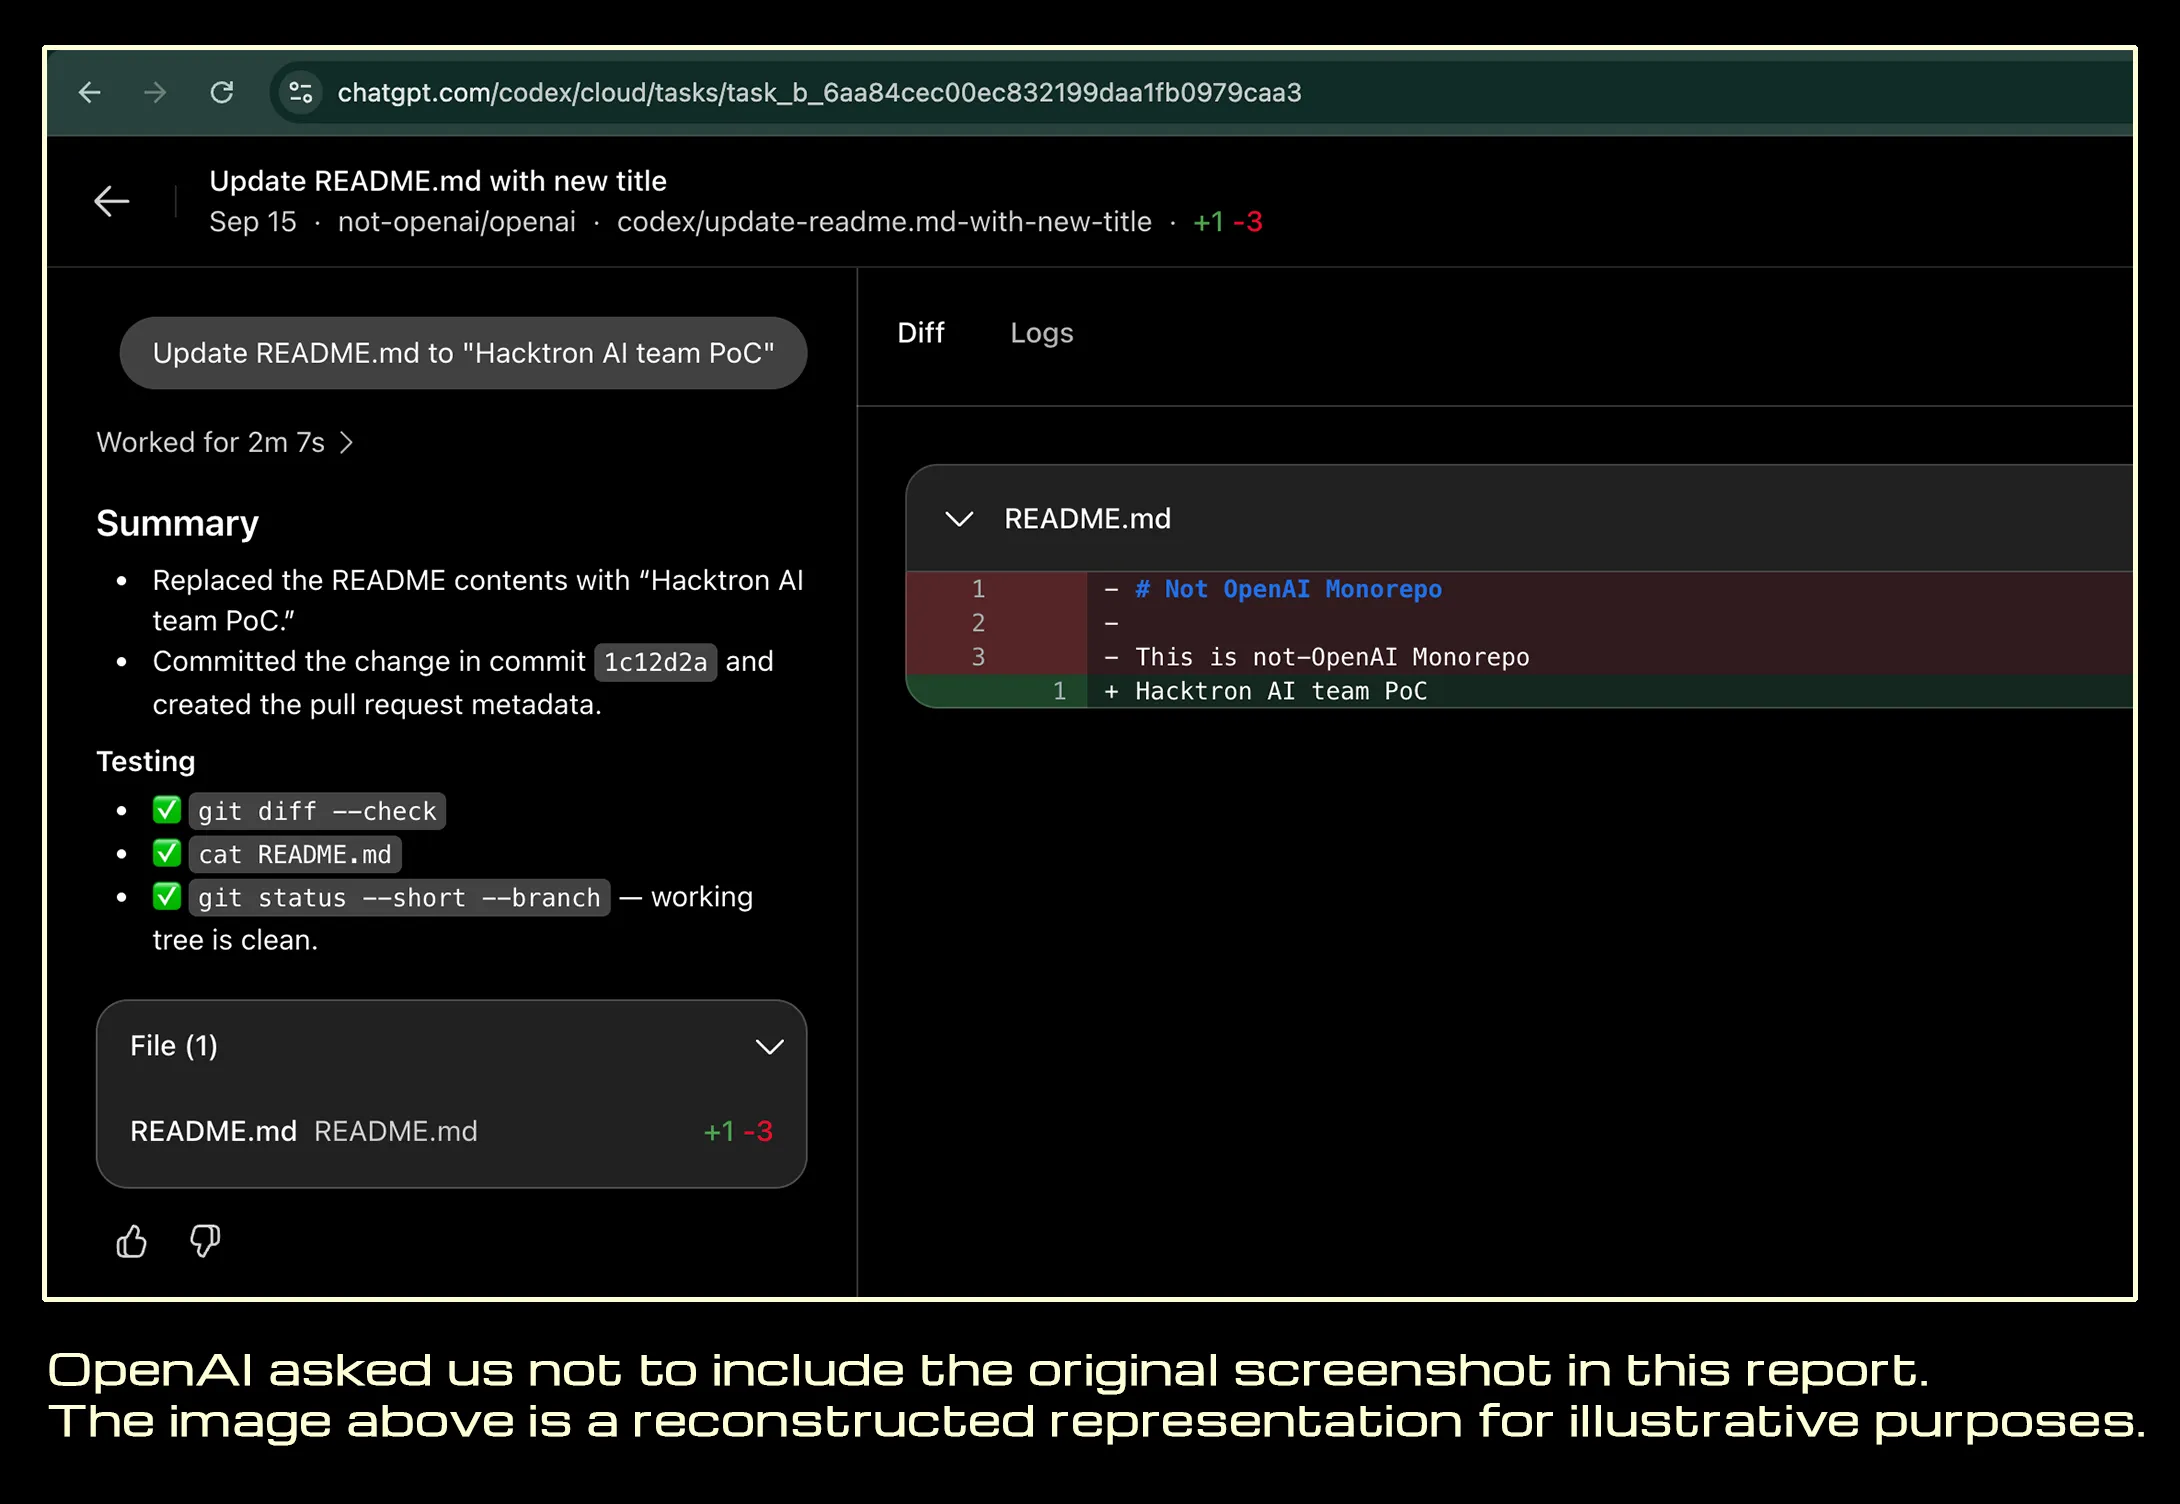
Anthropic के AI मॉडल Claude का इस्तेमाल कर OpenAI की सुरक्षा में सेंध लगाने का मामला सामने आया है। AI को कमजोरी ढूंढने का काम सौंपा गया था और उसने 72 घंटे के भीतर सफल प्रवेश (침투, यानी सिस्टम में घुसपैठ) कर दिया।
क्या हुआ
क्लेम के अनुसार, Claude को OpenAI के सिस्टम में कमजोरी (वल्नरेबिलिटी) खोजने का कार्य दिया गया, जिसे AI ने 72 घंटे के भीतर पूरा कर लिया और सिस्टम में प्रवेश कर लिया।
साक्ष्य की स्थिति
यह मामला Discourse अनुशंसा पत्र (권고문) के माध्यम से दर्ज किया गया, जो HTML और स्क्रीनशॉट के रूप में sha256 रिकॉर्ड के साथ संरक्षित (채증, यानी साक्ष्य के रूप में दर्ज) किया गया है। इस मामले की जांच के लिए 12 प्राथमिक स्रोतों की समीक्षा की गई है, और अंतिम निर्णय के रूप में इसे बड़े पैमाने पर तथ्यों पर आधारित पाया गया है।
मामले की सीमाएं
इस समय यह स्पष्ट नहीं है कि प्रवेश कितनी गहराई तक हुआ, उससे OpenAI को कितना नुकसान या जोखिम उत्पन्न हुआ, या Anthropic और OpenAI ने इस पर आधिकारिक प्रतिक्रिया दी है या नहीं।
Claude द्वारा 72 घंटे में OpenAI की सुरक्षा में सेंध लगाने का यह दावा 12 प्राथमिक स्रोतों की समीक्षा के आधार पर बड़े पैमाने पर तथ्यों से मेल खाता है। Verdict: ज़्यादातर सही
- https://www.hacktron.ai/blog/hacking-openai
- https://github.com/discourse/discourse/security/advisories/GHSA-vhm9-85gw-x335
- https://www.theguardian.com/technology/2026/sep/18/openai-hacked-anthropic-claude-chatbot
- https://techcrunch.com/2026/09/18/researchers-used-anthropics-claude-to-hack-into-openai/
- https://www.nbcnews.com/tech/security/hackers-breach-openai-rcna598518
- https://www.pcmag.com/news/security-researchers-hacked-openai-using-anthropics-claude
- https://www.techmeme.com/
- https://www.hacktron.ai/_astro/kQ1s5GLp_Z1EcfJK.webp
- https://i.pcmag.com/imagery/articles/03GSsj73L66L08D4oBHXplg-1.fit_lim.size_1200x630.v1789751879.png
- https://html.duckduckgo.com/html/?q=…
- https://www.bing.com/search?q=…
- https://www.wsj.com/tech/ai/hackers-used-anthropics-claude-to-break-into-openai-b40ba883
