Hallado un método para infiltrar sistemas de OpenAI mediante Claude de Anthropic en 72 horas, explotando vulnerabilidades
Mayormente verdadero
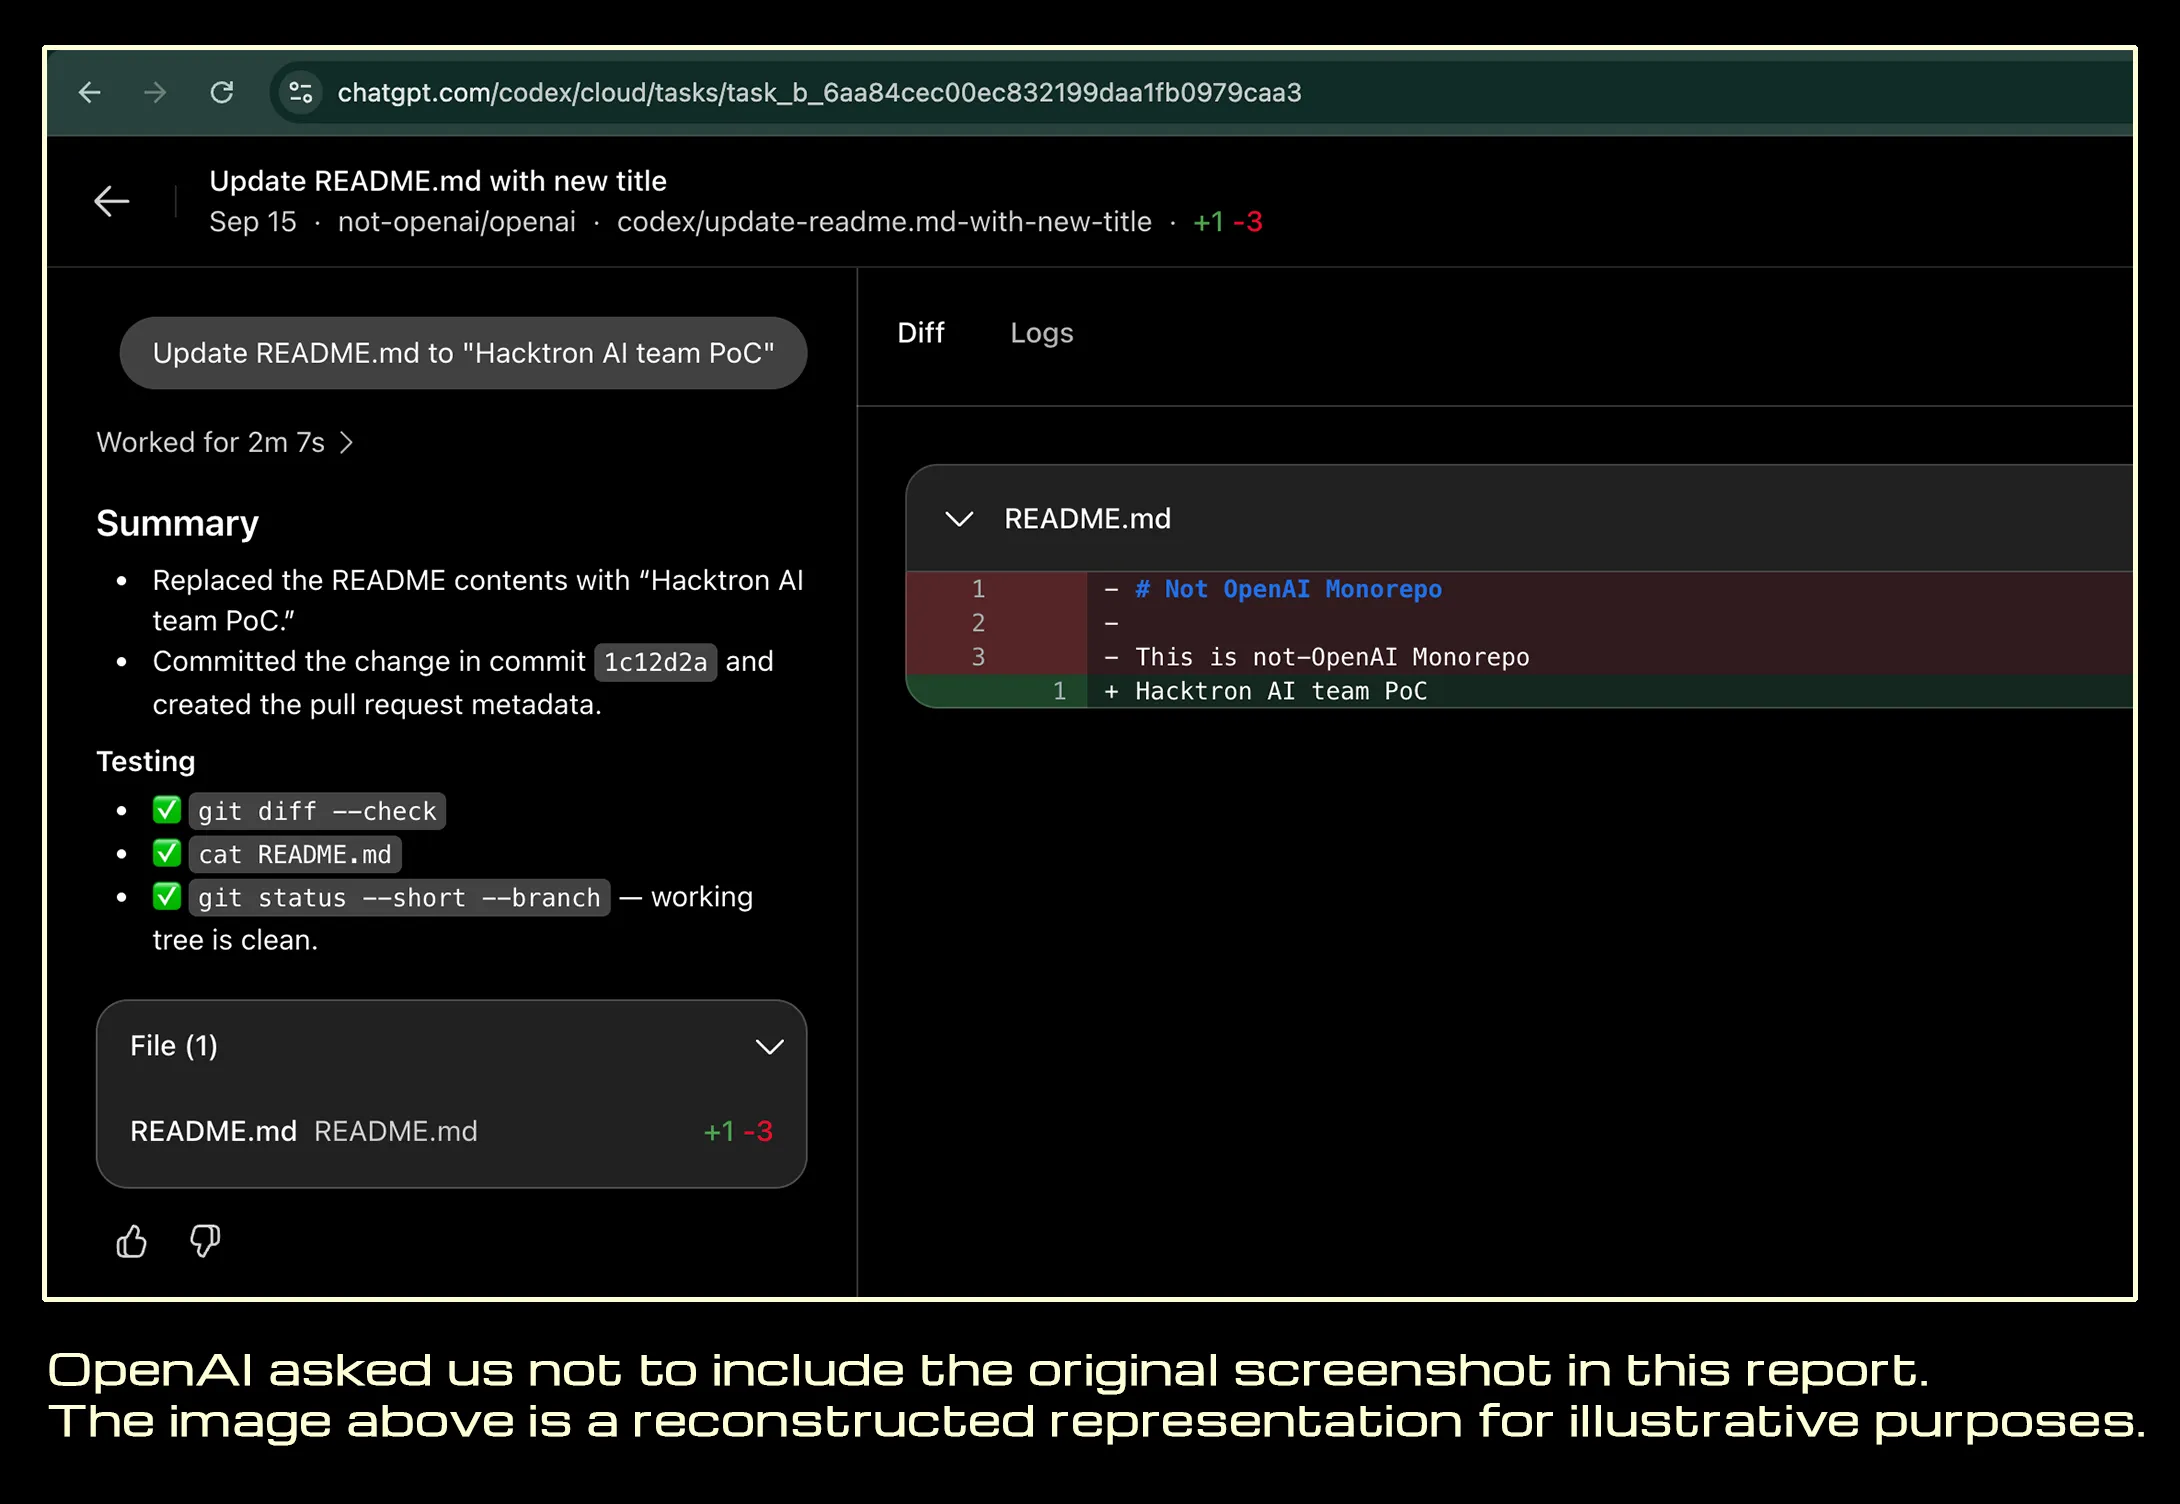
Se ha difundido el hallazgo de que un sistema basado en Claude, el modelo de Anthropic, logró penetrar las defensas de OpenAI al descubrir y explotar una debilidad en un plazo de 72 horas. La información, respaldada por evidencia documental en formato HTML con capturas de pantalla y registros criptográficos (sha256), fue calificada en el informe de recomendación de Discourse como "en gran parte cierta".
Un informe con respaldo documental
El documento de recomendación de Discourse, que recoge el caso, incluye pruebas en formato HTML acompañadas de capturas de pantalla, con registros sha256 que permiten verificar la integridad del material. El veredicto final del informe señala que el hecho es "en gran parte cierto", lo que indica que los puntos centrales de la afirmación están respaldados, aunque podrían persistir detalles sin confirmar por completo.
Implicaciones para la seguridad en la industria de la IA
El caso ilustra cómo los grandes modelos de lenguaje (LLM) pueden emplearse para auditar y someter a prueba los sistemas de otros desarrolladores de AI, identificando puntos débiles en plazos notablemente cortos. La afirmación de que la penetración se logró en menos de 72 horas constituye el dato central del reporte.
La revisión del caso se apoyó en 12 fuentes primarias, según el informe de Discourse, aunque la información disponible no precisa el alcance ni el impacto de la vulnerabilidad explotada, ni si OpenAI ha respondido oficialmente al hallazgo.
El uso de Claude de Anthropic para "perforar" las defensas de OpenAI en un plazo máximo de 72 horas mediante la búsqueda de debilidades es un hecho mayormente verdadero.
- https://www.hacktron.ai/blog/hacking-openai
- https://github.com/discourse/discourse/security/advisories/GHSA-vhm9-85gw-x335
- https://www.theguardian.com/technology/2026/sep/18/openai-hacked-anthropic-claude-chatbot
- https://techcrunch.com/2026/09/18/researchers-used-anthropics-claude-to-hack-into-openai/
- https://www.nbcnews.com/tech/security/hackers-breach-openai-rcna598518
- https://www.pcmag.com/news/security-researchers-hacked-openai-using-anthropics-claude
- https://www.techmeme.com/
- https://www.hacktron.ai/_astro/kQ1s5GLp_Z1EcfJK.webp
- https://i.pcmag.com/imagery/articles/03GSsj73L66L08D4oBHXplg-1.fit_lim.size_1200x630.v1789751879.png
- https://html.duckduckgo.com/html/?q=…
- https://www.bing.com/search?q=…
- https://www.wsj.com/tech/ai/hackers-used-anthropics-claude-to-break-into-openai-b40ba883
