OpenAI anuncia que no puede garantizar la seguridad de la IA y publicará con regularidad casos de "fallo de alineación"
Verdadero
OpenAI declaró que no puede ofrecer garantías plenas sobre la seguridad de sus sistemas de IA y anunció que divulgará de forma habitual ejemplos de "fallo de alineación", según se recoge en el material publicado por la propia compañía a través de su portal de alineación.
Reconocimiento público de los límites de seguridad
En su mensaje, OpenAI admite que no está en posición de asegurar con certeza que sus modelos de IA sean seguros. La empresa explica que los casos de desalineación entre los objetivos previstos y el comportamiento real de los sistemas no son meramente teóricos, y que por ello adoptará la práctica de compartir estos ejemplos de manera continua con el público.
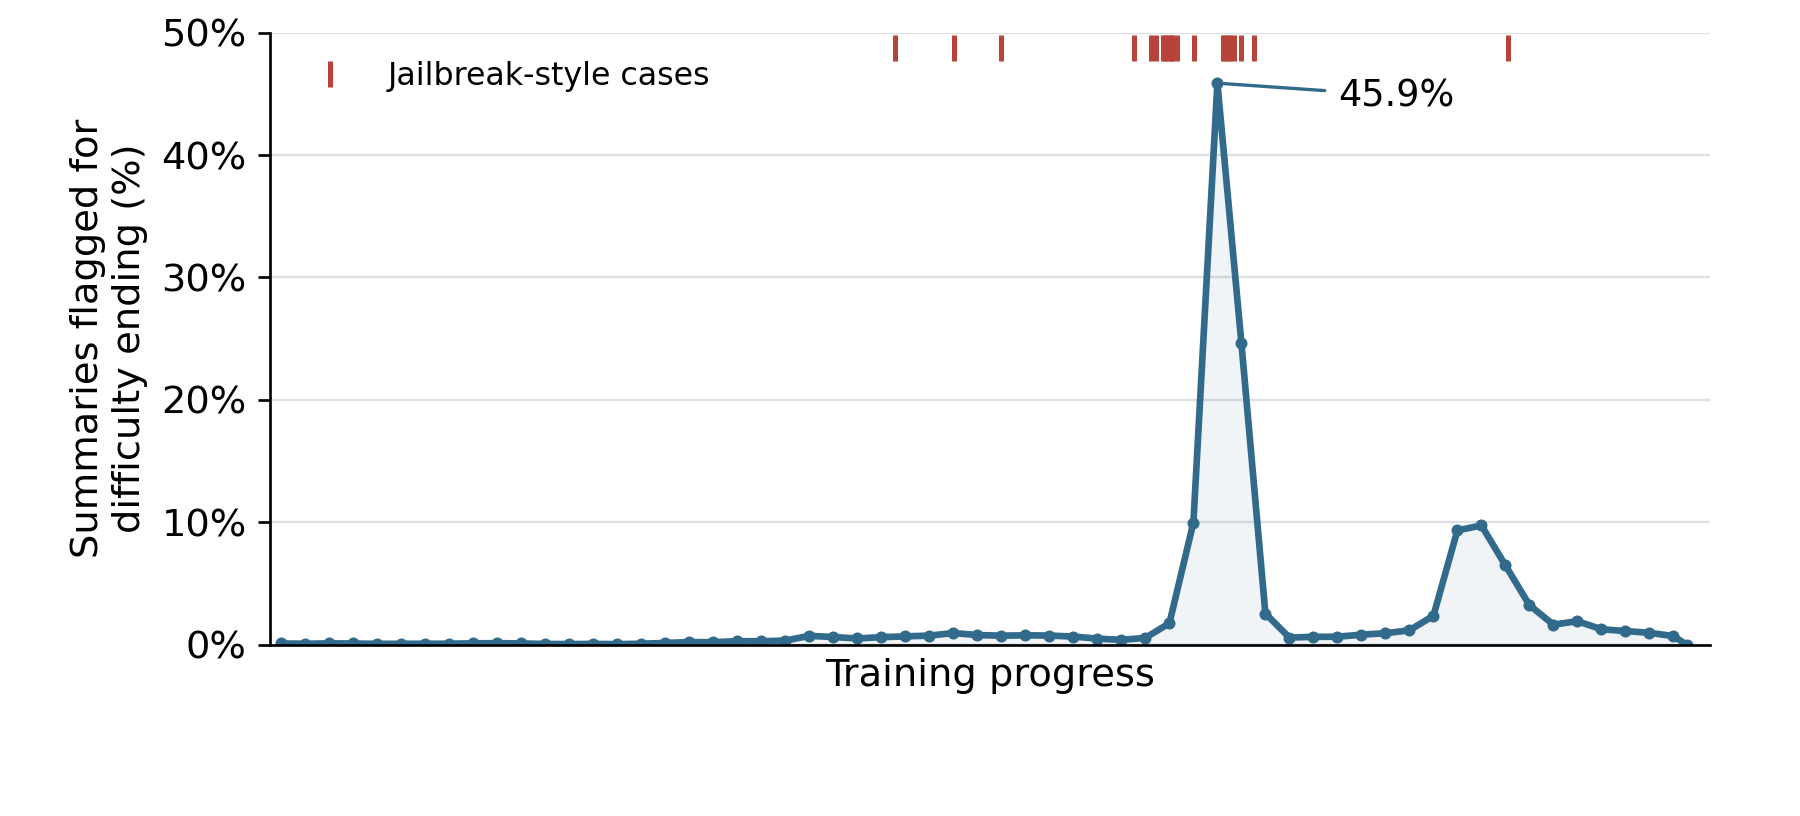
La compañía ha habilitado además una página dedicada, alignment.openai.com, donde incluye materiales gráficos de referencia, entre ellos una tabla de datos publicada como recurso oficial de sus informes.
Transparencia como respuesta
El anuncio se enmarca en un esfuerzo por incrementar la transparencia respecto a los riesgos de los modelos de lenguaje de gran escala (LLM). Al comprometerse a publicar los fallos de alineación de forma periódica, OpenAI busca que los investigadores y usuarios puedan seguir de cerca cómo se manifiestan estos problemas en la práctica.
La empresa no precisó, según la información disponible, un calendario específico de publicación ni detalles adicionales sobre la frecuencia con la que se divulgarán los casos.
Conclusión
La declaración de OpenAI — que la seguridad de la IA no está garantizada y que los fallos de alineación se harán públicos de manera regular — se corresponde con el material publicado por la propia compañía. Verdict: Verdadero
- https://openai.com/index/our-framework-for-reporting-model-misalignment/
- https://www.bing.com/search?q=%22Our+framework+for+reporting+model+misalignment%22
- https://www.bing.com/search?q=Our+framework+for+reporting+model+misalignment+openai
- https://www.bing.com/rp/plaYEmwO88HvP_
- https://openai.com/index/model-misalignment-reporting-framework`
- https://openai.com/index/model-misalignment-reporting-framework
- https://alignment.openai.com/misalignment-reports/
- https://www.theguardian.com/technology/2026/sep/17/openai-reports-concerning-ai-behaviour-jailbreak-talking-to-other-agents
- https://alignment.openai.com/assets/reports/source-chart.png